Tinatapatan ng maliit na Chinese AI computer ang mas mahal na karibal
Tinatarget ng Sipeed ang presyong humigit-kumulang $3,999 para sa MaixStation computer na may 128 GB na memorya at gumagamit ng AX8860P ng Chinese chipmaker na Axera. May sukat itong 11 by 11 by 3 cm at nangangakong patakbuhin nang lokal ang malalaking AI model sa karaniwang konsumo na 40 watts. Ang nilalayon nitong karibal ay ang DGX Spark ng Nvidia, isang compact AI system na nagkakahalaga ng humigit-kumulang $6,950 para sa 128 GB.
Mga Nilalaman
- Tinatapatan ng maliit na Chinese AI computer ang mas mahal na karibal
- Ano ang laman ng AX8860P ng Axera
- Bakit mas mahalaga ang 128 GB kaysa sa malaking TOPS sa headline
- Mas makitid na larawan ang ipinapakita ng opisyal na benchmark page
- Bakit kailangang maingat na ikumpara ang mga naunang pahayag tungkol sa bilis
- Maliit na kahong may karaniwang storage
- Nangangako ng dagdag na kapasidad ang mas maraming chip, pero pahayag pa lamang ang scalability
- Mahalaga sa pang-araw-araw na paggamit ang pangako ng software
- Nakabatay na ngayon sa campaign ang presyo at paghahatid
- Mahahalagang Punto
Ipinakilala ng Axera ang chip sa isang industrial exhibition sa Shanghai noong October 13, 2026, kung kailan ipinakita rin ng Sipeed ang MaixStation. Kapansin-pansin ang paunang pahayag: 25% na mas mabilis sa pagproseso ng mga prompt at 30% na mas mabilis sa pagbuo ng mga sagot kaysa sa DGX Spark kapag nagpapatakbo ng Qwen model na may 27 bilyong parameter, sa presyong humigit-kumulang kalahati ng katapat nito.
Mas detalyadong larawan ang ibinibigay ngayon ng pahina ng produkto ng MaixStation ng Sipeed. Nakatala rito ang 592 hanggang 677 token kada segundo sa pagproseso ng mga prompt sa Qwen3.8-27B at 6 hanggang 7 token kada segundo sa pagbuo ng mga sagot. Mas mababa ang mga bilang na ito kaysa sa mga saklaw na kumalat kasabay ng anunsyo, samantalang itinakda ng opisyal na plano sa paglulunsad ang Kickstarter campaign sa pagtatapos ng 2026.
Malinaw ang pang-akit nito: dahil sa malaking memorya sa maliit na computer, maaaring magpatakbo ang mga developer, opisina at indibidwal na user ng mga modelong may kakayahan nang hindi umuupa ng cloud computing o bumibili ng maraming graphics card. Gayunman, nakasalalay ang desisyon sa pagbili sa pinal na software, nasukat na performance at iskedyul ng paghahatid, bukod pa sa mga detalye ng chip.
Ano ang laman ng AX8860P ng Axera
Gumagamit ang AX8860 family ng 6-nanometer na proseso sa pagmamanupaktura at pinagsasama ang 16 Arm Cortex-A55 CPU core at isang nakalaang neural processing unit, o NPU. Processor ang NPU na idinisenyo para magsagawa ng mga paulit-ulit na kalkulasyong ginagamit ng mga AI model. Ayon sa Axera at Sipeed, kaya nito ang hanggang 256 trilyong operasyon kada segundo, na karaniwang pinaikli bilang 256 TOPS, gamit ang FP4.
Gumagamit ang FP4 ng apat na bit para mag-imbak ng mga numerikal na halaga. Kapag mas kaunti ang bit, mas kaunting memorya ang kailangan ng isang model at maaaring bumilis ang mga kalkulasyon, bagaman kailangang suportahan ng model at software ang format na iyon. Para sa dense computation ang bilang ng Axera, hindi para sa kalkulasyong ipinapalagay na maaaring laktawan ang ilang halaga gamit ang pamamaraang tinatawag na sparsity.
Sinusuportahan ng chip ang PCIe 5.0 at memory interface na may lapad na 256 bit. Itinatakda ng Sipeed ang LPDDR5X-8533 memory, hanggang 128 GB bawat module, at bandwidth na 273 GB kada segundo. May sukat na 78 by 78 mm ang Maix-V module nito at gumagamit ng LPCAMM2 connector.
Pinangangasiwaan ng Cortex-A55 core ang operating system at mga karagdagang gawain, samantalang nakalaan ang NPU sa pangunahing AI workload. May 20 Arm core ang DGX Spark ng Nvidia, kabilang ang mas malalakas na Cortex-X925 core, habang Zen 5 CPU naman ang gamit ng mga kalabang AMD Ryzen AI Halo machine. Kaya mas marami pang dapat ikumpara ang mga user na nagbabalak pagsabayin ang AI inference at mabibigat na karaniwang gawain sa computing, bukod sa accelerator lamang.
Bakit mas mahalaga ang 128 GB kaysa sa malaking TOPS sa headline
Kailangan ng isang language model ng memorya para sa mga numerikal na weight nito, na naglalaman ng natutuhan nito sa training, at para sa mga working data na nalilikha habang sumasagot ito sa isang kahilingan. Kung kulang ang memorya ng mabilis na accelerator, maaaring kailanganing hatiin ang model sa maraming device o ilipat ito sa mas mabagal na storage.
Inilalagay ng iminungkahing 128 GB configuration ng MaixStation ito sa kaparehong klase ng kapasidad ng memorya ng mas malaking DGX Spark. Pareho silang may nakatalang bandwidth na 273 GB kada segundo. May configuration na 128 GB at humigit-kumulang 256 GB kada segundo ang bandwidth sa AMD Ryzen AI Halo range, at may mas mahal na bersiyong 192 GB at 273 GB kada segundo.
Itinatakda ng kapasidad kung gaano karaming data ang kasya. Itinatakda naman ng bandwidth kung gaano kabilis maililipat ang impormasyon sa processor. Sa karaniwang pagbuo ng output ng isang dense language model, kailangang basahin ang malaking dami ng model data para makagawa ng bawat bagong token. Maliit na yunit ng teksto ang token, na kung minsan ay isang salita at kung minsan ay bahagi lamang nito.
Dahil dito, iginigiit ng Sipeed na sa mahusay na paggamit ng memorya, kayang makipagkumpitensya ng 256 TOPS processor nito sa mas malaking numerong ina-advertise ng Nvidia para sa computing. Gumagamit ng sparsity ang FP4 rating na humigit-kumulang 1,000 TOPS ng DGX Spark; nasa 500 trilyong operasyon kada segundo naman ang dense FP4 figure nito. Nakadepende rin ang aktuwal na bilis sa application kung gaano kahusay napapanatiling gumagana ang hardware ng software.
Mas makitid na larawan ang ipinapakita ng opisyal na benchmark page
Hinahati ng Sipeed ang mga pagsusuri nito sa prefill, kapag pinoproseso ng model ang prompt ng user, at decode, kapag bumubuo ito ng sagot. Maaaring paikliin ng mas mabilis na prefill ang paghihintay bago magsimula ang sagot, lalo na kapag mahahaba ang mga dokumento. Dahil naman sa mas mabilis na decode, mas mabilis na lumilitaw ang sagot kapag nagsimula na ang pagbuo nito.
Para sa Qwen3.8-27B sa dense FP4, inililista sa opisyal na pahina ang prefill ng MaixStation sa 592 hanggang 677 token kada segundo, kumpara sa 550 para sa DGX Spark. Katumbas ito ng lamang na humigit-kumulang 8% hanggang 23%. Nakatala ang bilis ng decode ng MaixStation sa 6 hanggang 7 token kada segundo, ngunit walang numerikal na batayang bilis ng decode para sa DGX Spark sa model na iyon sa tekstong ibinigay kasama ng opisyal na chart.
Para sa Qwen3.6-35B-A3B, isang mixture of experts model, inililista ng Sipeed ang prefill sa 2,664 hanggang 3,256 token kada segundo, kumpara sa 2,368 ng DGX Spark. Lumalabas sa kalkulasyon na humigit-kumulang 13% hanggang 38% ang lamang. Nasa 34 hanggang 37 token kada segundo ang decode, kumpara sa 34, mula sa tabla hanggang sa lamang na humigit-kumulang 9%.
Bahagi lamang ng network nito ang ina-activate ng mixture of experts model para sa bawat token. Nakakatulong itong ipaliwanag kung bakit mas mataas ang bilis ng pagbuo nito kaysa sa dense model na may katulad na kabuuang bilang ng parameter. Magkakaiba ang dami ng trabahong kailangan ng bawat uri ng model sa bawat token.
Inilalarawan ng Sipeed ang mga ipinakitang resulta bilang konserbatibong kasalukuyang sukat at sinasabing patuloy pang inaayos ang AX8860P. Nakasaad sa chart nito ang FP4 na naka-disable ang multi token prediction, o MTP. Isang pamamaraan ang MTP na sabay-sabay na nagmumungkahi ng ilang susunod na token upang pabilisin ang pagbuo ng teksto.
Bakit kailangang maingat na ikumpara ang mga naunang pahayag tungkol sa bilis
Mas mataas ang mga saklaw sa mga naunang benchmark na inilathala ng Sipeed: 1,400 hanggang 1,600 token kada segundo para sa prefill ng Qwen3.8-27B at 15 hanggang 17 para sa decode, kumpara sa mga batayang bilang ng DGX Spark na 1,300 at 13. Para sa mixture of experts model, 6,300 hanggang 7,700 ang mga saklaw sa prefill at 80 hanggang 88 sa decode, kumpara sa 5,600 at 80. Nagbigay rin ang Sipeed ng mas huling paghahambing na nagsasabing humigit-kumulang 10% ang lamang ng MaixStation sa dalawang yugto, at hindi opisyal ang mga mas bagong pagsusuring nagpapakita ng mas malaking lamang.
Dahil mas mababa ang mga ganap na bilang sa opisyal na pahina, lalong mahalagang isaalang-alang ang mga kondisyon ng pagsusuri. Maaaring magbago ang resulta batay sa haba ng prompt, bilang ng mga kahilingang sabay-sabay pinoproseso, mga numerikal na format, runtime software at bersiyon ng driver. Umabot sa humigit-kumulang 11.5 hanggang 11.6 token kada segundo ang mga independent DGX Spark run para sa Qwen3.8-27B na binanggit sa pag-uulat, nang walang speculative decoding; mula 840 hanggang 1,900 naman ang prefill depende sa software.
Ipinapaliwanag ng isang payak na kalkulasyon sa memorya kung bakit pinagtuunan ng pansin ang naunang pahayag na 17 token kada segundo. Kung humigit-kumulang 16 GB ang ginagamit ng model na tumatakbo, ang paghahati sa 273 GB kada segundo sa 16 GB ay nagbubunga ng humigit-kumulang 17 token kada segundo, bago ibawas ang ibang trapiko sa memorya. Para maabot ang bilis na iyon, kailangang magamit nang pambihirang husay ang ina-advertise na bandwidth.
Mahalaga rito ang aktuwal na laki ng memoryang kailangan ng model. Kapag minultiply ang apat na bit sa 27 bilyong parameter, humigit-kumulang 13.5 GB ang kailangan para sa mga weight lamang, habang maaaring lumaki pa ang working size dahil sa numerical scaling data at iba pang imbakan. Makakatulong sa mga mamimili ang detalyado at nauulit na pagsusuri para maiugnay ang mga bilang ng bilis sa partikular na configuration ng model.
Maliit na kahong may karaniwang storage
Batay sa ina-advertise na sukat ng MaixStation, 363 cubic centimetres ang volume nito. Inihahambing ito ng Sipeed sa 1,125 cubic centimetres ng DGX Spark, kaya humigit-kumulang sangkatlo ng volume ang iminungkahing kahon nito. Ayon sa kumpanya, maaaring paganahin ang machine sa pamamagitan ng USB-C mula sa angkop na power bank na may rating na 65 watts.
Nakatala sa opisyal na pahina ang karaniwang konsumo na 40 watts para sa MaixStation at 120 watts para sa DGX Spark. Mga karaniwang workload na iniulat ng Sipeed ang mga ito. Tinukoy rin sa unang ulat tungkol sa AX8860 ang 40 watts para sa nakalaang module, kaya makakatulong sa mga susunod na pagsusuri ang paglilinaw kung ano mismo ang saklaw ng mga sukat ng konsumo.
Kabilang sa mga koneksiyon ang 10G SFP+ networking, USB-C, MCIO 8i connector at karaniwang M.2 2280 slot para sa SSD. Pamilyar na paraan ang format ng storage para makapagdagdag ng espasyo ang mga mamimili para sa mga model file, na mabilis makakakonsumo ng daan-daang gigabyte.
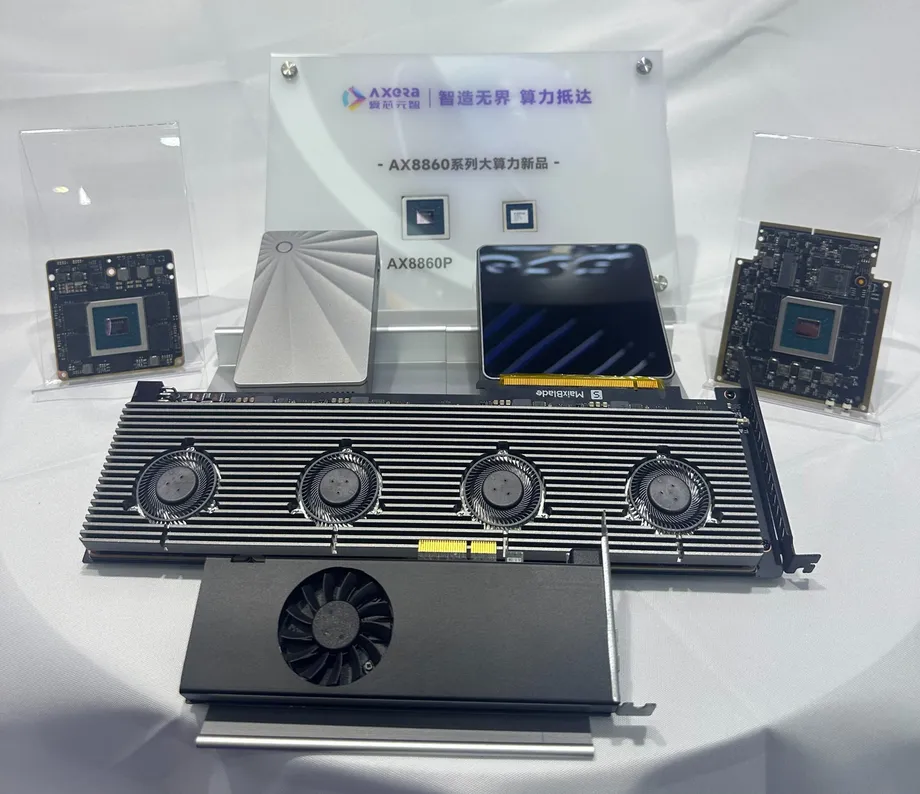
Hindi lamang sa maliliit na desktop nakatuon ang mga plano ng Axera sa hardware. Kabilang sa mga disenyo ang module, PCIe card na may isang chip, at card na may apat na chip, apat na fan at karaniwang power connector na may walong pin. Iniuugnay ng Sipeed ang MaixStation Pro at MaixBlade sa mga configuration na may 512 GB o higit pa.
Nangangako ng dagdag na kapasidad ang mas maraming chip, pero pahayag pa lamang ang scalability
Ayon sa Sipeed, makakapagkonekta ang MaixStation ng hanggang walong node nang walang panlabas na switch, gamit ang koneksiyon sa pagitan ng mga chip na may rating na 256 gigabit kada segundo at maaaring palawakin sa 384 gigabit kada segundo. Gumagamit ang DGX Spark ng 200-gigabit na koneksiyon para mag-ugnay ng mga system, at kailangan ng panlabas na switch sa configuration na may apat na Spark.
Mahalagang pag-ibahin ang gigabit at gigabyte. Katumbas ng 32 gigabyte kada segundo ang raw na bilis ng koneksiyong may rating na 256 gigabit kada segundo, bago isaalang-alang ang overhead. Iba at mas mabilis na koneksiyon sa loob ng bawat machine ang tinutukoy ng memory bandwidth na 273 gigabyte kada segundo.
Nagtatala ang Axera ng pinagsamang 512 TOPS para sa dalawang chip at 1,024 TOPS para sa apat, kasama ang pahayag na nasa 80% ang scaling efficiency. Mula sa laboratory simulation ang scaling figure para sa apat na chip. Lumilikha rin ng dagdag na komunikasyon at koordinasyon ang paghahati ng model sa mga processor, kaya hindi lamang pagdaragdag ng pinakamataas na computing rating ng mga ito ang batayan ng bilis sa application.
Binabanggit sa roadmap ng Axera ang AX8950 na aabot sa 500 TOPS at AX8970 na lalampas sa 700 TOPS. Magbibigay ng mga susunod na upgrade ang mga planadong processor na ito, ngunit nakasalalay ang agarang alok ng MaixStation sa AX8860P at software nito.
Mahalaga sa pang-araw-araw na paggamit ang pangako ng software
Naglilista ang Sipeed ng Debian 13 na may Linux 6.18, kasama ang suporta para sa vLLM, SGLang, PyTorch, llama.cpp at Ollama. Tumutulong ang mga tool na ito sa pag-load ng mga model, paghahatid ng mga kahilingan at pagkonekta ng mga AI application sa hardware. Ina-advertise din ng kumpanya ang mga API na tugma sa OpenAI at Anthropic, kaya makapagpapadala ng mga kahilingan ang mga dati nang application sa lokal na device.
Ipinaliliwanag sa FAQ ng produkto ng Sipeed na nasa ibabaw ng software na isinulat para sa Axera hardware ang mga pamilyar na pangalan ng framework:
Tumatakbo ang SGLang at vLLM sa pamamagitan ng pasadyang backend na nagpapabilis sa hardware at gumagamit ng mga kernel na isinulat sa AXDSL.
Maliliit na bahagi ng software ang mga kernel na nagsasagawa ng mga pangunahing kalkulasyon sa accelerator. Ayon sa Sipeed, direktang makakapag-load ang mga user ng mga suportadong Hugging Face model, samantalang maaaring mangailangan ng mga kernel na isinulat sa AXDSL ang mga bagong arkitektura ng model. Nangangako itong ilathala ang mga kernel at tool sa development, at sinasabing kasalukuyang ginagawa ang pagbubukas sa publiko ng software development kit ng AX8860.
Ina-advertise ng kumpanya na handa na sa pagsisimula ang mga model at browser interface. Kabilang sa mga mungkahing gamit nito ang coding agent, pagproseso ng dokumento, pagbuo ng video at robotics. Mga Linux host muna ang susuportahan ng mga PCIe card; nakadepende sa demand ang suporta sa Windows. Noong anunsyo, inaasahang magiging handa ang NPU toolchain sa pagtatapos ng October.
Nakabatay na ngayon sa campaign ang presyo at paghahatid
Humigit-kumulang $2,951, o 42%, na mas mababa ang inaasahang presyong $3,999 ng Sipeed para sa 128 GB kumpara sa DGX Spark na nagkakahalaga ng $6,950. Malaki ang diskuwento, bagaman hindi bababa sa kalahati ang presyo. Ilalagay din nito ang MaixStation malapit sa presyong humigit-kumulang $3,999.99 ng AMD Ryzen AI Halo na may 128 GB.
Nagbago ang iskedyul ng paglulunsad mula sa paunang inaasahang darating ang mga device sa 2026. Bukas na ang mga reservation, ngunit itinatakda ng opisyal na FAQ ang Kickstarter sa pagtatapos ng 2026. Sinabi ng Sipeed na layunin nitong magpadala ng mga produkto sa loob ng tatlong buwan matapos magsara ang campaign.
- October 13, 2026: Ipinakilala ng Axera ang AX8860 family sa Shanghai, at ipinakita ng Sipeed ang MaixStation.
- Pagtatapos ng October 2026: Inaasahan ng Sipeed na magiging handa na ang NPU toolchain.
- Pagtatapos ng 2026: Plano ng Sipeed na ilunsad ang Kickstarter campaign para sa MaixStation.
- Sa loob ng tatlong buwan matapos magsara ang campaign: Target na petsa ng pagpapadala ayon sa Sipeed.
Hindi pa kinukumpirma ng Sipeed ang pinal na retail price, tiyak na petsa ng paghahatid o performance ng MaixStation na napatunayan ng mga independiyenteng pagsusuri. Hindi pa rin tiyak ang kapasidad sa produksyon, mga kasunduan sa suporta, at presyo at iskedyul ng 512 GB Pro version. Plano ang remote access at mga review unit habang isinasagawa ang campaign, na magbibigay sa mga posibleng mamimili ng susunod na pagkakataong suriin ang mga pahayag.
Mahahalagang Punto
- Tinatarget ng MaixStation ang presyong humigit-kumulang $3,999 para sa 128 GB na memorya at Axera AX8860P processor na may rating na 256 TOPS sa dense FP4.
- Nagtatala ang Sipeed ng memory bandwidth na 273 GB kada segundo, karaniwang konsumo na 40 watts at kahong may sukat na 11 by 11 by 3 cm.
- Mas mababang ganap na bilis ang ipinapakita sa opisyal na benchmark page kaysa sa mga naunang inilathalang saklaw, at nag-iiba ang mga resulta ayon sa model at yugto ng pagproseso.
- Nakasalalay ang suporta sa software sa pasadyang Axera acceleration backend, at ipinangakong ilalabas sa publiko ang mga tool sa development at iba pang code.
- Plano ang Kickstarter sa pagtatapos ng 2026, kasunod ang target na pagpapadala sa loob ng tatlong buwan mula nang magsara ang campaign.
- Mga independiyenteng pagsusuri, pinal na presyo at tiyak na pangako sa paghahatid ang magtatakda kung paano maihahambing ang iminungkahing system sa mga alternatibo ng Nvidia at AMD.