Gumaganang GPU at pahayag na 5% na mas mataas ang throughput
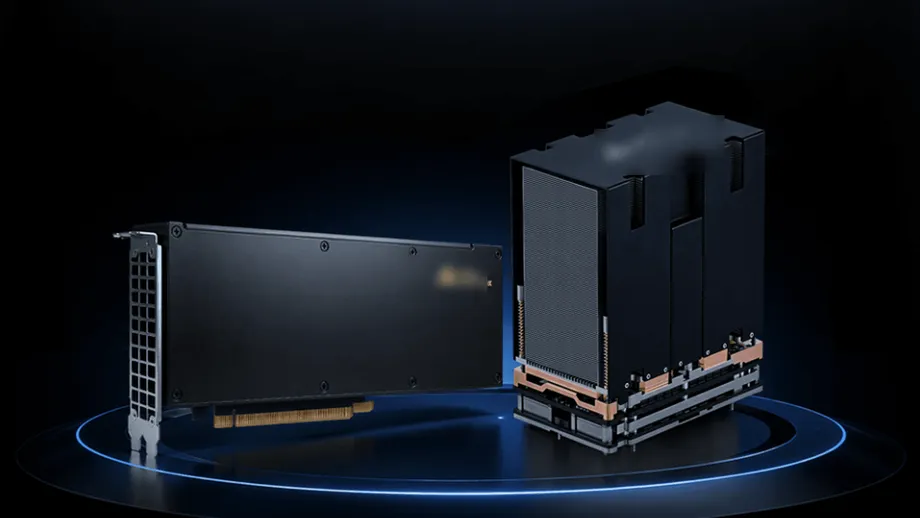
Ipinakita ng Iluvatar CoreX sa publiko sa Shanghai ang graphics processor nitong Tiangai 300, bilang alternatibong Tsino sa H200 ng Nvidia, at sinabing may 5% itong kalamangan sa isang pagsubok ng inference ng third party. Sa media open day nito noong Oktubre 28, 2026, ipinakita rin ng kumpanya ang isang sistemang pang-training na may walong GPU at inilarawan ang isang rack na naglalaman ng 144 GPU at 18 CPU.
Mga Nilalaman
- Gumaganang GPU at pahayag na 5% na mas mataas ang throughput
- Ano ang sinusukat ng paghahambing sa H200
- Mahahabang dokumento at mas mabilis na unang tugon
- Ibang Nvidia processor ang ginamit na batayan sa mga resulta ng training
- Mula sa paglulunsad noong Hulyo hanggang sa demonstrasyon noong Oktubre
- Rack na binuo para sa 144 GPU
- Paghahati ng gawain ng AI sa iba't ibang chip
- Layunin ng mga pahayag tungkol sa software na paikliin ang deployment
- Dinadala ng TY1200 ang alok sa larangan ng robotics
- Mahahalagang punto
Nagmula ang pangunahing paghahambing sa pagsubok na isinagawa ng Shanghai Electric Group noong Hulyo, ayon sa Iluvatar CoreX. Sa deployment na pinaghiwalay ang dalawang yugto ng pagproseso ng large language model, nakamit ng Tiangai 300 ang end-to-end throughput na katumbas ng 1.05 beses ng H200 matapos i-convert ang mga resulta sa sukatan kada card.
Ang throughput ay tumutukoy sa dami ng kapaki-pakinabang na gawaing natatapos ng isang sistema sa takdang panahon. Para sa chatbot, maaaring mangahulugan ito ng dami ng tekstong nalilikha nito bawat segundo. Ang resultang 1.05 beses ng batayang performance ay nangangahulugan ng 5% na mas maraming output sa mga kundisyon ng pagsubok na iyon.
Inilarawan ng kumpanya ang Tiangai 300 bilang unang general-purpose GPU ng Tsina na umabot sa performance ng H200 sa mga isinagawang pagsukat. Pinalawak ng demonstrasyon nito noong Oktubre ang paghahambing sa mga language model, paglikha ng imahe at paglikha ng video, habang ginamit naman sa hiwalay na demonstrasyon ng training ang H100 ng Nvidia bilang batayan.
Higit pa sa mga espesipikasyon ng chip ang ipinakita sa kaganapan. Iniharap ng Iluvatar CoreX ang mga card, server, siksik na disenyo ng rack, software tool at paraan ng paghahati ng mga gawain sa AI sa iba't ibang uri ng processor. Ipinupunto ng kumpanya sa komersiyal na alok nito na kayang makalikha ng kapaki-pakinabang na output ng AI ang mga bahaging ito nang mas mura at mas kaunti ang paghihintay.
Ano ang sinusukat ng paghahambing sa H200
Gumamit ang pagsubok ng Shanghai Electric Group noong Hulyo ng paghihiwalay ng prefill at decode, na madalas paikliing PD separation. Ang prefill ang yugtong binabasa ng language model ang kahilingan ng user at mga kaugnay na materyal. Ang decode naman ang yugtong bumubuo ito ng sagot, paisa-isang token. Ang mga token ay maliliit na yunit na pinaghahati-hatian ng mga AI system ang teksto.
Sa paghihiwalay ng mga yugtong ito, maaaring maglaan ang sistema ng magkakaibang resource para sa pagbasa at pagsulat. Kaya ang resulta ng Tiangai 300 ay tumutukoy sa isang partikular na ayos ng deployment, kung saan ipinahayag ang kabuuang performance bilang katumbas na bilang para sa isang card.
Hindi inilathala ng Iluvatar CoreX ang detalyadong pamamaraan ng pagsubok, listahan ng mga model o mga kundisyon ng workload sa likod ng pangunahing resulta ng third party. Kailangan ang mga detalyeng ito, pati ang kalkulasyon ng conversion at mga setting ng software, upang maulit nang hiwalay ang pagsubok. Wala ring inilathalang breakdown ang paghahambing sa gastos, at kailangan pang linawin ang mga memory figure ng bawat card at ng buong rack.
Nagbibigay ng mas detalyadong larawan ng mga pahayag ng kumpanya ang mga demonstrasyong pinangalanan ng performance laboratory nito. Inilalarawan ng mga ito ang iba't ibang pagbuti para sa iba't ibang gawain, mula sa maliit na pagtaas sa paglikha ng multimedia hanggang sa mas malaking pag-angat sa throughput ng rekomendasyon. Para sa mamimili, ang mahalagang paghahambing ay nakabatay sa gawaing aktuwal na pinapatakbo ng sarili nilang serbisyo.
Mahahabang dokumento at mas mabilis na unang tugon
Umabot sa 1.05 beses ng performance ng H200 ang attention performance ng Tiangai 300 sa context length na 64K, ayon sa laboratoryo ng kumpanya. Ang attention ang prosesong tumutulong sa modelo na tukuyin kung aling mga bahagi ng input nito ang may kaugnayan sa isa't isa. Ang context length na 64K ay nangangahulugang humahawak ang modelo ng humigit-kumulang 64,000 token.
Sa GLM-5.3 sa kaparehong laki ng context, sinabi ng Iluvatar CoreX na umabot sa 1.15 beses ng performance ng H200 ang throughput nito habang pinananatili ang katumbas na karanasan ng user. Katumbas ito ng 15% na pagtaas para sa sinubok na workload ng mixture-of-experts. Itinatalaga ng mixture-of-experts model ang gawain sa piling mga espesyalistang network sa halip na gamitin ang lahat ng network para sa bawat token.
Para sa mga workload ng AI agent na may context na mula 8K hanggang 128K, iniulat ng kumpanya ang pagbawas na humigit-kumulang 10% hanggang 30% sa paghihintay sa unang output token. Mahalaga ang sukatang ito sa taong naghihintay na magsimulang sumagot ang assistant matapos nitong magbasa ng mahabang dokumento o magproseso ng masalimuot na kahilingan.
Bahagi rin ng demonstrasyon ang paglikha ng imahe at video. Iniulat ng kumpanya ang pagtaas na humigit-kumulang 2% hanggang 5% sa throughput ng multimodal generation kumpara sa H200. Para sa mga workload ng online search, advertising at rekomendasyon, sinabi nitong 21% na mas mataas ang throughput ng inference ng rekomendasyon at 26% na mas mababa ang latency para sa magaang pagkukuwenta.
Ibang Nvidia processor ang ginamit na batayan sa mga resulta ng training
Gumamit sa demonstrasyon ng training ng Qwen3-32B, isang modelong may humigit-kumulang 32 bilyong parameter, sa server na may walong GPU. Ang mga parameter ay mga numerikal na value na ina-adjust ng modelo habang nagte-training upang matutuhan ang mga pattern. Sinabi ng Iluvatar CoreX na umabot sa 1.33 beses ng sa H100 ng Nvidia ang epektibong throughput kada card.
Kaya 33% ang iniulat na kalamangan sa demonstrasyong iyon ng training, kung saan H100 ang ginamit na chip sa paghahambing. H200 naman ang ginamit na batayan sa iba pang resulta ng inference sa kaganapan. Mahalagang paghiwalayin ang mga batayang produktong ito upang maunawaan ang mga numero.
Gumagana ang sistema ng training sa FP8 precision. Gumagamit ang FP8 ng walong bit sa pag-iimbak ng mga numero, kaya nababawasan ang dami ng datos na kailangang ilipat at iproseso kumpara sa mga format na gumagamit ng mas maraming bit. Kailangang maingat na pangasiwaan ng software ng AI training ang mas mababang precision na ito upang mapanatili ang kalidad ng pagkatuto.
Iniulat din ng Iluvatar CoreX na 0.43% ang pagbabago-bago sa step time sa matagalang operasyon nang todo ang load, kumpara sa 0.76% para sa isang reference system na batay sa Hopper. Ang step time ay panahong kailangan upang matapos ang paulit-ulit na yunit ng gawain. Makakatulong sa mga operator ang mas pare-parehong timing upang matantiya kung gaano karaming gawain ang matatapos ng sistemang abala.
Mula sa paglulunsad noong Hulyo hanggang sa demonstrasyon noong Oktubre
Pormal na ipinakilala ang Tiangai 300 sa World Artificial Intelligence Conference noong Hulyo 2026. Ginagamit nito ang arkitekturang Tianshu ng kumpanya, may bagong henerasyon ng Tensor Cores at tinukoy na may 144GB na graphics memory.
Sinusuportahan ng processor ang scalar, vector at tensor operations. Sa payak na paliwanag, pinoproseso ng mga ito ang mga indibidwal na numero, pangkat ng mga numero at mas malalaking hanay ng matematika. Kabilang sa mga sinusuportahang numerical format ang FP4, FP8, FP16 at BF16, na nagbibigay sa mga software developer ng iba't ibang pagpipilian para sa bilis, paggamit ng memory at numerical precision.
Saklaw ng ilang buwan ang mga pampublikong milestone na inilarawan ng kumpanya:
- Hulyo 2026: Inilunsad ang Tiangai 300 sa World Artificial Intelligence Conference.
- Hulyo 2026: Isinagawa ng Shanghai Electric Group ang pagsubok ng third party na binanggit para sa paghahambing ng throughput sa H200.
- Bago ang media event noong Oktubre: Ipinakita ang disenyo ng IXL144 rack sa China International Industry Fair.
- Oktubre 28, 2026: Binuksan ng Iluvatar CoreX sa media sa Shanghai ang mga live na demonstrasyon ng hardware ng Tiangai 300.
Dinala ng kaganapan noong Oktubre ang kuwento ng produkto mula sa mga presentasyon ng arkitektura tungo sa mga sistemang nagpapatakbo ng mga pinangalanang workload. Umaabot na ngayon ang saklaw ng deployment na inilarawan ng kumpanya mula sa mga indibidwal na accelerator card hanggang sa mga server na may walong card at sa mas malaking sistemang IXL144.
Rack na binuo para sa 144 GPU
Pinagsasama ng IXL144 ang 144 GPU at 18 CPU sa iisang standard na rack, na may pinagsamang GPU memory na humigit-kumulang 10.1TB, ayon sa Iluvatar CoreX. Inilarawan ito ng kumpanya bilang pinakasiksik na GPU supernode sa industriya na nakalagay sa iisang rack. Pinagdurugtong nang malapitan ng supernode ang maraming processor upang makapagtulungan ang mga ito sa malalaking gawain.
Kailangan ng mas malinaw na breakdown ng configuration upang maipaliwanag ang tinukoy na 144GB kada Tiangai 300 at ang nakasaad na kabuuang 10.1TB ng rack. Kapag minultiply ang 144 card sa 144GB, magiging 20,736GB ito, bago isaalang-alang ang mga pagkakaiba sa paraan ng pagkalkula ng kapasidad. Kailangang tukuyin sa paglalarawan ng rack ang configuration ng mga card at ang kapasidad ng memory na magagamit ng mga workload.
Tinataya ng Iluvatar CoreX na kayang bawasan ng sistema nang humigit-kumulang 40% ang gastos kada milyong epektibong token kumpara sa mga pangunahing internasyonal na sistema. Tumutukoy ang epektibong token sa output na binibilang bilang kapaki-pakinabang na gawain. Para sa mga operator na nagbebenta ng serbisyo ng AI, iniuugnay ng sukatang ito ang gastos sa hardware sa dami ng nagawang output na mapapakinabangan.
Ang 40% na pagbawas ay mangangahulugan ng gastos na 60 yunit para sa gawaing nagkakahalaga ng 100 yunit sa sistemang pinaghahambingan. Nakadepende ang aktuwal na matitipid sa presyo ng kagamitan, konsumo ng kuryente, software, workload at kung gaano kapare-parehong nagagamit nang husto ang mga GPU.
Inilarawan din ng kumpanya ang target para sa susunod na henerasyon ng peer-to-peer interconnect engine nito: bawasan mula 3 hanggang 5 microsecond tungo sa 1 microsecond ang iisang paglilipat ng datos sa loob ng magkakaugnay na saklaw. Nakakatulong ang mas mabilis na komunikasyon kapag magkakaibang bahagi ng modelo ang hawak ng iba't ibang GPU at kailangan ng mga ito na paulit-ulit na magpalitan ng datos.
Paghahati ng gawain ng AI sa iba't ibang chip
Inilalaan ng heterogenous deployment approach ng Iluvatar CoreX ang iba't ibang bahagi ng inference sa magkakaibang uri ng processor. Sa ilalim ng AFD separation scheme nito, pinangangasiwaan ng Tiangai 300 ang buong yugto ng prefill at ang mga kalkulasyon ng attention habang nagde-decode. Pinangangasiwaan naman ng XPU ng katuwang na kumpanya ang mga feed-forward expert network.
Pangkalahatang tawag ang XPU para sa ibang uri ng computing accelerator. Layunin ng paraang ito na ibigay sa bawat processor ang gawaing pinakamainam nitong napangangasiwaan habang pinag-uugnay ng iisang scheduler ang buong gawain. Isinasagawa ng mga feed-forward network ang isa pang malaking bahagi ng mga kalkulasyon sa loob ng language model.
Iniulat ng kumpanya ang 60% na pagbawas sa latency ng inference habang nagde-decode sa ilalim ng pinag-isang scheduling. Iba ang configuration ng sistemang ito sa pangunahing pahayag na 5% na mas mataas ang throughput kaysa H200, at iba rin ang sukat ng performance na ginagamit.
Sinabi ni Shan Tianyi, pinuno ng AI at accelerated computing ng kumpanya, na nakasalalay ang mga sistema ng computing para sa AI sa hinaharap sa mahusay na pagsasaayos ng iba't ibang chip, sa halip na umasa sa iisang uri ng processor para sa lahat ng gawain. Isinasalin ng AFD demonstration ang estratehiyang ito sa kongkretong kaayusan ng mga GPU at accelerator ng katuwang na kumpanya.
Layunin ng mga pahayag tungkol sa software na paikliin ang deployment
Ipinakita rin ng Iluvatar CoreX ang software stack na tinawag nitong AI for AI, na nilayong awtomatikuhin ang ilang bahagi ng deployment at optimization. Sinabi ng kumpanya na bumaba mula isang oras tungo sa 10 minuto ang isang gawain sa pag-set up ng environment, habang nabawasan mula ilang dosena tungo sa isa ang bilang ng mga manu-manong operasyon.
Para sa isang gawain sa pag-optimize ng malaking modelo, iniulat ng kumpanya na pinaikli nito ang proseso mula pitong araw tungo sa wala pang dalawang oras, habang halos dumoble ang performance. Tumutukoy ang mga halimbawang ito sa gawaing pang-engineering na kailangan upang mapatakbo nang mahusay ang mga modelo sa hardware.
Sinabi rin ng kumpanya na malalim ang integrasyon nito sa FlyDSL, isang wikang ginagamit sa pagbuo ng mga GPU computation routine. Ayon dito, bumilis nang mahigit 90% ang compilation at dati-rati'y nangangailangan ng 10 tao na magtrabaho nang isang araw ang isang workflow, ngunit natatapos na ito ng isang tao sa loob ng ilang oras.
Mahalaga ang suporta ng software dahil hindi sapat ang mahusay na hardware para sa pagkukuwenta lamang. Kailangang magtulungan ang mga modelo, mathematical library at tool sa deployment. Tinutugunan ng mga demonstrasyon ng software kung gaano karaming gawaing pang-engineering ang maaaring kailanganin ng mga customer bago nila gawing gumaganang serbisyo ang bagong GPU.
Dinadala ng TY1200 ang alok sa larangan ng robotics
Itinampok din sa kaganapan sa Shanghai ang Tongyang TY1200, isang hiwalay na processor na nakatuon sa AI PC at embodied intelligence, kabilang ang mga robot na nakadama at kumikilos sa pisikal na mundo. Ang tinukoy nitong dense compute capability ay 300 TOPS, o 300 trilyong operasyon kada segundo. Binibilang ng dense compute ang gawain nang hindi umaasa sa paglaktaw sa mga kalkulasyong kinasasangkutan ng mga serong value.
Sinabi ng Iluvatar CoreX na umabot sa 1.2 beses ng performance ng Thor T5000 ng Nvidia ang TY1200 sa mga pagsubok gamit ang Qwen3.8-27B at Qwen3.6-35B-A3B. Para sa mga modelong Cosmos-R2-2B at Cosmos-R2-8B sa mga sitwasyon ng physical AI, iniulat nitong katumbas ng 158% at 180% ng batayan na Thor T5000 ang performance, ayon sa pagkakasunod.
Sinabi rin ng kumpanya na kayang magpatakbo ng TY1200 ng physics simulation na pinabibilis ng GPU gamit ang MuJoCo-Warp. Dahil dito, kayang gayahin ng sistema para sa pagbuo ng robot ang mga galaw, magsanay ng control policy at subukan ang mga kilos nang lokal. Ang control policy ay hanay ng mga natutuhang tagubilin na ginagamit ng robot upang magpasya kung paano kikilos.
Kabilang sa mga iniulat na aplikasyon ang mga robot na tumutulong sa mga tao sa mga pagbisita para sa pangangalagang medikal, machine vision sa industriya at paggabay sa mga bisita. May tinukoy na compute target na 600T ang nakaplanong kahalili nitong TY2000. Pinapalawak ng mga produktong ito ang estratehiya ng kumpanya mula sa malalaking AI server tungo sa kagamitang gumagana malapit sa mga user at makina.
Mahahalagang punto
- Ipinakita ng Iluvatar CoreX sa Shanghai ang hardware ng Tiangai 300 noong Oktubre 28, 2026.
- Binanggit ng kumpanya ang pagsubok ng Shanghai Electric Group bilang batayan ng throughput kada card na katumbas ng 1.05 beses ng performance ng H200 ng Nvidia.
- Ayon sa ulat, naghatid ang demonstrasyon ng training ng Qwen3-32B gamit ang walong GPU ng throughput kada card na katumbas ng 1.33 beses ng H100 sa FP8 precision.
- Hindi pa nailalathala ang detalyadong pamamaraan sa likod ng pangunahing benchmark ng third party.
- May 144 GPU at 18 CPU ang IXL144 rack, at inaangkin nitong nakakabawas ng 40% sa gastos kada milyong epektibong token.
- Ayon sa ulat, nabawasan nang 60% ang latency sa pagde-decode sa hiwalay na deployment na naghahati ng gawain sa mga GPU at XPU.
- Saklaw din ng kaganapan ang pag-automate ng software at mga aplikasyon ng TY1200 sa lokal na AI at simulation ng robotics.