Iisang recipe sa pagmamanupaktura para sa tatlong supplier ng memorya
Hiniling ng Nvidia sa Samsung Electronics, SK hynix at Micron na gamitin ang 3nm manufacturing process ng TSMC para sa mga base die ng susunod nitong henerasyon ng custom high bandwidth memory, ayon sa mga ulat ng industriya na inilathala noong Oktubre 18, 2026. Iniulat na tinanggap ng Device Solutions division ng Samsung ang kahilingan matapos ang panloob na pagsusuri, kaya naging katuwang nito ang karibal na Taiwanese foundry sa isang bahagi ng pagmamanupaktura ng memorya na tradisyonal na ginagawa mismo ng Samsung.
Mga Nilalaman
- Iisang recipe sa pagmamanupaktura para sa tatlong supplier ng memorya
- Ano ang nagbabago sa loob ng memory stack?
- Bakit nais ng Nvidia ang iisang proseso sa lahat ng supplier
- Patuloy na gagamitin ng Samsung ang sarili nitong mga pabrika
- Magkakaiba ang tinatahak ng Micron at SK hynix
- Ano ang ibig sabihin ng mga bilang ng performance ng Nvidia
- Iniuugnay ng Amazon ang memorya sa mas malawak na platform ng Nvidia
- Ang pag-usbong ng pagbabagong ito
- Mahahalagang Punto
Ang produktong tinatawag na NVHBM ay nakabatay sa HBM4E, ang ikapitong henerasyon ng high bandwidth memory. Nais din ng Nvidia na gamitin ng mga supplier ang ikaanim na henerasyon ng teknolohiya sa pagmamanupaktura ng DRAM para sa mga memory die, na tinatawag na 1c. Layunin nitong maging mas pare-pareho ang paggana ng memorya mula sa iba't ibang supplier at mabawasan ang gawaing pang-inhinyeriya para maaprubahan ang produkto ng bawat supplier.
Palalawakin ng desisyon ng Samsung ang dati nang ugnayan nito sa TSMC mula sa pagiging magkatugma sa packaging tungo sa pagmamanupaktura ng HBM. Nagtulungan ang mga kumpanya apat na taon na ang nakararaan upang matiyak na maikokonekta ang memorya ng Samsung sa mga graphics processor sa pamamagitan ng teknolohiya sa packaging ng TSMC. Mas pinalalawak pa ng paggawa ng mahalagang chip sa loob ng memory stack ang pagtutulungang ito.
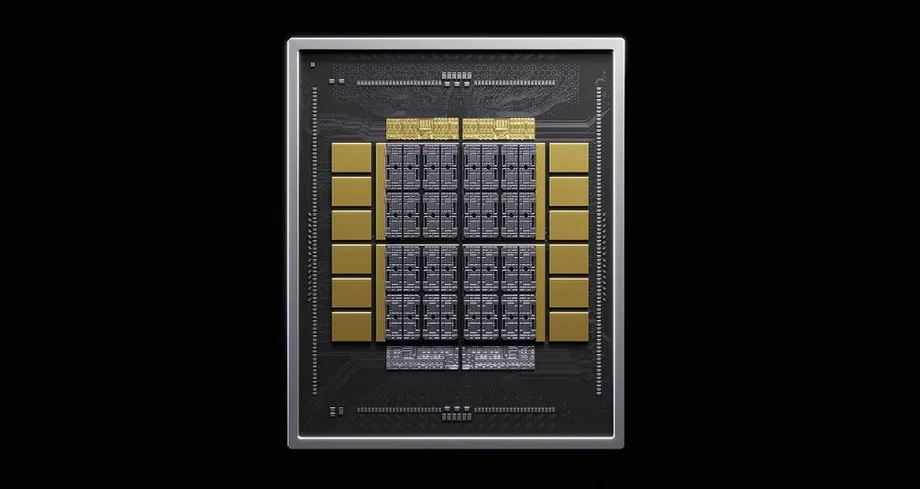
Binabago rin ng panukala ng Nvidia ang tungkulin ng base die. Inililipat ng NVHBM ang memory controller, ang circuitry na namamahala sa daloy ng data, mula sa pangunahing processor papunta sa ilalim ng memory stack. Dahil dito, nagiging mas mahalagang bahagi ng computing system ang base die sa halip na simpleng koneksyon lamang sa pagitan ng memorya at processor.
Para sa Samsung, nangangahulugan ang pagtanggap sa arkitekturang ito ng paghihiwalay sa dalawang desisyong dati nitong pinagsasama: kung sino ang gagawa ng memoryang nag-iimbak ng impormasyon at kung sino ang gagawa ng logic chip na namamahala sa koneksyon nito sa processor. Patuloy na magsusuplay ng memorya ang Samsung habang ang TSMC naman ang gagawa ng itinakdang base die.
Ano ang nagbabago sa loob ng memory stack?
Inilalagay sa HBM ang ilang memory die na magkakapatong sa tabi ng isang makapangyarihang processor. Dahil sa ganitong pagkakaayos, nakapaglalakbay ang maraming data sa maiikling distansya, kaya napapanatiling may sapat na impormasyon ang mga computing unit ng AI accelerator. Ang die ay isang indibidwal na piraso ng silicon na naglalaman ng mga electronic circuit.
Nag-iimbak ng data ang mga core die. Nasa ilalim ng mga ito ang base die, na namamahala sa mga koneksyon at logic function. Sa karaniwang ayos, nananatili sa pangunahing accelerator die ang memory controller. Inililipat ng NVHBM ang controller na iyon sa base die, kaya nagkakaroon ng puwang sa processor para sa iba pang circuitry.
Gumagamit din ang Nvidia ng custom physical interface na tinatawag na PHY upang pagdugtungin ang mga chip. Ang PHY ang circuitry na nagpapadala at tumatanggap ng mga electrical signal. Ayon sa mga teknikal na paglalarawan ng NVHBM, pinapalitan nito ang malapad at parallel na interface na karaniwang gamit sa HBM ng mas makitid at pagmamay-ari na serialized na koneksyon, na nagpapadala ng data sa mas kaunting koneksyon ngunit mas mabilis.
Makikita sa laki ng karaniwang interface kung bakit kaakit-akit ang pagbabagong ito. May 32 channel ang HBM4, na bawat isa ay 64 bit ang lapad, kaya umaabot sa 2,048 bit ang kabuuang lapad. Nangangailangan ng maraming circuitry at masalimuot na wiring sa pagitan ng mga chip ang pamamahala sa mga koneksyong ito. Layunin ng NVHBM na bawasan ang pasaning iyon at pasimplehin ang pagruruta sa interposer, ang nagdurugtong na layer sa ilalim ng mga chip.
Iniaalok ng Nvidia ang NVHBM bilang building block para sa mga custom silicon partner sa pamamagitan ng NVLink Fusion. Nananatiling hiwalay na kategorya ng produkto ang karaniwang HBM. Gagamitin ng mga partner na pipili sa NVHBM ang tinukoy ng Nvidia na disenyo ng controller at koneksyon bilang bahagi ng sarili nilang mga accelerator system.
Bakit nais ng Nvidia ang iisang proseso sa lahat ng supplier
Pinagsasama ng iminungkahing recipe sa pagmamanupaktura ng Nvidia ang 3nm logic process ng TSMC at mga advanced na proseso ng DRAM para sa mga memory layer. Magkakaiba ang tungkulin ng logic at DRAM at magkaiba rin ang mga paraang ginagamit sa pagmamanupaktura ng mga ito. Tinutukoy ng label na 3nm ang isang henerasyon ng pagmamanupaktura ng logic, samantalang henerasyon ng teknolohiya ng DRAM ang tinutukoy ng 1c.
May kanya-kanyang disenyo at paraan ng produksyon ang Samsung, SK hynix at Micron. Dahil sa mga pagkakaibang ito, maaaring kailanganin ng dagdag na pagsusuri kapag nais bumili ng memorya mula sa mahigit isang kumpanya ang isang developer ng accelerator. Nagbibigay sa mga developer ng mas pare-parehong panimulang punto ang iisang proseso para sa base die.
Nangangahulugan ang validation ng pagsuri kung gumagana nang magkakasama ang processor, memorya at package sa itinakdang bilis, antas ng konsumo ng kuryente at pagiging maaasahan. Kumakain ng oras sa pag-iinhinyero ang pag-uulit ng prosesong ito para sa magkakaibang implementasyon. Layunin ng panukala ng Nvidia na bawasan ang hiwa-hiwalay na gawaing kailangan upang maisama ang mga bahagi kapag nagpapalit ng supplier ng memorya.
Tinatawag ng Micron na 1-gamma ang paparating nitong henerasyon ng DRAM, na halos katumbas ng henerasyong 1c sa katawagang ginagamit ng Samsung at SK hynix. Kaya pinagbubuklod ng iisang target ang mga henerasyon ng pagmamanupaktura na may magkakaibang pangalan sa bawat kumpanya, sa halip na gawing magkapareho ang proseso ng memorya ng lahat ng supplier.
Magiging iisang katuwang sa pagmamanupaktura ang TSMC para sa magkakakumpitensyang produkto ng memorya. Maaari nitong pasimplehin ang implementasyon ng Nvidia sa iba't ibang supplier habang itinutuon sa iisang foundry ang isang mahalagang hakbang sa produksyon. Ipinakikita ng pagsusuri ng Samsung sa isang alternatibong ruta sa pagmamanupaktura kung gaano kahalaga ang pagtiyak na sapat ang supply ng mga base die.
Patuloy na gagamitin ng Samsung ang sarili nitong mga pabrika
Planong panatilihin ng Samsung ang pinagsamang modelo ng pagmamanupaktura nito para sa karaniwang HBM. Ginagamit ng mga produktong HBM4 at HBM4E nito ang sarili nitong 4nm process para sa base die at 1c process para sa mga core die. Ginagawa ang mga memory layer sa mga kampus nito sa Hwaseong at Pyeongtaek sa South Korea.
Sinimulan ng Samsung ang maramihang produksyon ng HBM4 noong unang bahagi ng 2026, habang isinasailalim pa sa qualification para sa maramihang produksyon ang HBM4E nang lumabas ang ulat noong Oktubre. Ang qualification ay yugto ng pagsusuri upang matiyak kung handa nang gawin nang tuloy-tuloy ang isang produkto ayon sa hinihinging pamantayan.
Inaasahang pananatilihin din ng Samsung ang pinagsamang paraan nito sa paggawa ng custom HBM para sa iba pang customer, kabilang ang AMD. Samakatuwid, partikular sa mga kinakailangan ng Nvidia ang desisyon tungkol sa NVHBM, sa halip na hakbang ng buong kumpanya na itigil ang paggawa ng mga base die sa sarili nitong pasilidad.
Inaasahang pangungunahan ng Memory Business ng Samsung ang suporta sa disenyo at pag-optimize para sa mga base die na gagawin ng TSMC. Babaguhin nito ang hatian ng mga responsibilidad sa loob ng Samsung, kung saan tradisyonal na nag-aambag ang System LSI at ang Foundry business sa mga base die na kinukuha sa loob ng kumpanya.
Sinusuri rin ng Samsung kung kaya ng sarili nitong foundry na gumawa ng mga base die ng NVHBM sakaling lumampas ang demand sa kapasidad ng TSMC. Magbibigay ang iminungkahing alternatibong ito ng isa pang opsyon sa produksyon, bagaman nakatuon sa 3nm process ng TSMC ang kasalukuyang espesipikasyong iniulat ng Nvidia.
Magkakaiba ang tinatahak ng Micron at SK hynix
Hindi lamang sa custom na produkto para sa Nvidia nakatuon ang pagbabago ng Micron. Ayon sa kumpanya, gagamit ng mga base die na gagawin ng external foundry ang NVHBM na binubuo nito kasama ang Nvidia at ang karaniwang HBM4E nito. Inaasahang TSMC ang mamamahala sa pagmamanupaktura.
Para sa HBM4, pinagtatambal ng Micron ang mga memory die na ginawa gamit ang 1-beta process nito at ang base die na ginagawa sa loob ng kumpanya. Ililipat ng HBM4E ang mga memory layer sa 1-gamma at ang produksyon ng base die palabas ng mga pabrika ng Micron. Kaya binabago ng Micron ang dalawang pangunahing bahagi ng stack: gagamit ito ng mas bagong proseso para sa memorya habang gumagamit din ng panlabas na katuwang sa pagmamanupaktura ng logic.
Inaasahan ni Manish Bhatia, chief operating officer ng Micron, na magkakaroon ang NVHBM ng mas mataas na average selling price at mas malaking margin. Ayon sa kanya, premium na ang presyo ng HBM, at nagdaragdag pa ng halaga ang mga dagdag na gawain at tungkuling kasama sa pag-customize. Kaya maaaring kaakibat ng inaasahang mas malaking kakayahang kumita ang pagpapaubaya sa iba ng paggawa ng base die.
Gumagamit na ang SK hynix ng 12nm logic process ng TSMC para sa mga base die ng HBM4. Ipinahihiwatig ng mga ulat ng industriya na binibigyan ng prayoridad ang 3nm process ng TSMC para sa HBM4E at sa mga susunod na custom HBM. Magdadala ang pagbabagong ito ng mas advanced na pagmamanupaktura ng logic sa isang bahaging magkakaroon ng dagdag na mga tungkulin.
Nagpakita rin ang SK hynix ng konsepto ng custom HBM na nakabatay sa teknolohiyang Stream DQ nito sa event na GTC ng Nvidia noong unang bahagi ng taon. Nakatuon ang konsepto sa tuloy-tuloy na pamamahala at pagpapadaloy ng data sa mga processor. Sa lahat ng tatlong supplier, iisa ang direksyon: gawing mas aktibong bahagi sa paglilipat ng data ang base die.
Ano ang ibig sabihin ng mga bilang ng performance ng Nvidia
Ayon sa Nvidia, makapagbibigay ang NVHBM ng hanggang 30% na mas malaking bandwidth kada stack kaysa sa karaniwang HBM4E at gagamit ng 15% na mas kaunting kuryente ang HBM. Sinusukat ng bandwidth kung gaano karaming data ang maililipat sa loob ng takdang panahon. Makakatulong ang mas malaking bandwidth sa AI processor na naghihintay ng impormasyon mula sa memorya.
Sa isang simpleng paghahambing, kung 100 unit ng data ang naihahatid ng karaniwang HBM4E stack sa takdang panahon, itataas iyon ng pinakamataas na ipinahayag na pagbuti ng Nvidia sa 130 unit. Kung 100 unit ng kuryente ang ginagamit ng memoryang pinaghahambingan, ibababa ng ipinahayag na pagbawas sa konsumo ang paggamit ng HBM sa 85 unit. Isinasalin lamang ng mga halimbawang ito ang mga porsiyento at hindi inilalarawan ang mga partikular na produktong ibinebenta.
Binabanggit din ng Nvidia ang pagpapalaya ng hanggang 25% ng lawak ng XPU compute die. Pangkalahatang katawagan ang XPU para sa computing processor, kabilang ang mga custom AI accelerator. Nagkakaroon ng puwang ang mga designer para maglaan ng mas malaking bahagi ng silicon sa mga tungkuling pangkompyutasyon kapag inililipat ang circuitry ng memorya palayo sa processor.
Sa isa pang ulat tungkol sa presentasyon ng Nvidia, binanggit ang hanggang 30% na dagdag sa computing capacity sa pangunahing die. Sinusukat nito ang potensyal na computing resources, samantalang inilalarawan ng bilang na 25% ang lawak ng silicon na napapalaya dahil sa pagbabago ng arkitektura. Kailangan pa ring magpasya ng mga designer kung paano gagamitin ang nabakanteng puwang.
Ayon sa paglalarawan, mababawasan nang hanggang 67% ng custom PHY ang lawak na sinasakop ng interface. Hango ang pagtatayang ito sa pagbawas ng bilang ng pin. Ginagamit ng mas malawak na paghahambing ng Nvidia sa bandwidth, konsumo ng kuryente at lawak ang karaniwang HBM4E bilang batayan, sa panahong hindi pa naipapadala ang henerasyong iyon.
Para sa isang serbisyong AI, makatutulong ang mas mabilis na paglilipat ng data upang mas mabilis makabuo ng mga tugon kapag memorya ang naglilimita sa bilis. Maaaring magbigay sa mga system designer ng mas malaking puwang sa badyet sa kuryente ang mas mababang konsumo ng memorya. Nakadepende ang epekto sa isang buong server sa processor, workload, networking at cooling, bukod pa sa memorya.
Iniuugnay ng Amazon ang memorya sa mas malawak na platform ng Nvidia
Ang Annapurna Labs ng Amazon ang unang inihayag na partner ng NVHBM. Gumagawa ang negosyong ito sa disenyo ng chip ng mga Trainium accelerator para sa Amazon Web Services, kaya nagkakaroon ang Nvidia ng paraan upang magsuplay ng teknolohiya ng memorya sa isang kumpanyang gumagawa rin ng sarili nitong mga AI processor.
Inilarawan ni Nafea Bshara, vice president sa Annapurna Labs, ang layunin ng pakikipagtulungan sa mga pahayag na kalakip ng anunsyo:
Inaasahan namin ang pakikipagtulungang ito sa teknolohiya upang makinabang dito ang mga disenyo ng imprastraktura ng AWS sa hinaharap.
Inaasahang susuportahan ng Trainium 4 ng Annapurna ang NVLink Fusion. Inilalagay ng mga ulat tungkol sa paglulunsad ng NVHBM ang pagpapakilala nito alinman sa Trainium 4 o sa susunod pang henerasyon; hindi pa napagpapasiyahan sa publiko ang eksaktong henerasyon ng chip at petsa ng komersiyal na paglabas ng implementasyon ng NVHBM ng Amazon.
Nagbibigay ang NVLink Fusion ng access sa mga partner sa mga teknolohiyang kabilang ang NVLink Chiplet, NVLink-C2C, NVLink Switch at mga sistema at rack ng MGX. Naglalaan ang mga ito ng mga koneksyon at disenyo ng sistema upang maisama ang mga custom processor sa imprastraktura ng computing ng Nvidia. Idinadagdag ng NVHBM ang memory subsystem sa koleksiyong ito.
Iniulat na pinagtibay ng MediaTek ang NVLink Fusion limang araw matapos ang anunsyo ng NVHBM at planong ialok ito sa sarili nitong mga customer ng XPU. Nagbibigay ito sa Nvidia ng isa pang daan papunta sa mga proyekto ng custom accelerator, isang pamilihang kinabibilangan din ng Broadcom at Marvell. Inilarawan na ng Marvell noong Disyembre 2024 ang maihahambing na paraan ng paglilipat ng kontrol sa memorya, kaya mahahalagang bahagi ng kompetisyon ang pagtanggap ng mga customer at pagsasama nito sa mga sistema.
Ang pag-usbong ng pagbabagong ito
Pinagsasama ng pagbuo sa NVHBM ang mga pagbabago sa arkitektura, ugnayan sa mga supplier at pagtanggap ng mga customer. Ipinapaliwanag ng pagkakasunod-sunod ng mga pangyayari kung bakit mahalaga ang desisyon ng Samsung noong Oktubre: unang iniharap ng Nvidia ang iisang disenyo, saka kailangang magpasya ng mga tagagawa ng memorya kung paano nila ito gagawin.
- Disyembre 2024: Inilarawan ng Marvell ang maihahambing na konsepto na may ibang pagkakalagay ng mga tungkulin sa pagkontrol ng memorya.
- Unang bahagi ng 2026: Sinimulan ng Samsung ang maramihang produksyon ng HBM4, habang iniharap naman ng SK hynix ang konsepto nitong custom HBM na Stream DQ sa GTC.
- Agosto 26, 2026: Inanunsyo ng Nvidia ang NVHBM bilang dagdag sa NVLink Fusion at pinangalanan ang Annapurna Labs bilang unang partner nito.
- Pagkalipas ng limang araw: Iniulat na pinagtibay ng MediaTek ang NVLink Fusion at planong ialok ito sa mga customer nitong XPU.
- Oktubre 18, 2026: Inilarawan sa mga ulat ng industriya ang kahilingan ng Nvidia para sa mga base die na gagamit ng TSMC 3nm at ang pagtanggap dito ng Samsung matapos ang panloob na pagsusuri.
Inilalapit ng desisyon ng Samsung ang plano sa pagmamanupaktura sa layunin ng Nvidia na magkaroon ng pare-parehong implementasyon sa iba't ibang supplier ng memorya. Kasabay nito, pinananatili ng patuloy na pamumuhunan ng Samsung sa sarili nitong mga base die ang ibang ruta para sa karaniwang HBM at mga custom na produktong ibinibigay sa iba pang customer.
Mahahalagang Punto
- Iniulat na nais ng Nvidia na gamitin ng Samsung, SK hynix at Micron ang 3nm process ng TSMC para sa mga base die ng NVHBM.
- Inililipat ng NVHBM ang memory controller mula sa pangunahing processor papunta sa base die ng HBM stack.
- Tinanggap ng Samsung ang kahilingan ngunit planong ipagpatuloy ang panloob na pagmamanupaktura para sa karaniwang HBM at iba pang custom na produkto.
- Planong ipagawa ng Micron sa labas ang mga base die para sa NVHBM at karaniwang HBM4E; katuwang na ng SK hynix ang TSMC sa HBM4.
- Ayon sa Nvidia, makapagbibigay ang NVHBM ng hanggang 30% na mas malaking bandwidth at 15% na mas mababang konsumo ng kuryente ng HBM kumpara sa karaniwang HBM4E.
- Ang Annapurna Labs ng Amazon ang unang inihayag na partner, habang sinusuri ng Samsung kung maaaring gawing alternatibong lugar ng produksyon ang sarili nitong foundry.