Isang modelong natututo sa mga titik ng RNA at sa mga ugnayan ng mga ito
Inilabas ng mga mananaliksik sa University of Science and Technology of China ang structRFM, isang bukas na foundation model para sa RNA na sinanay gamit ang 21 milyong pares ng mga sequence ng RNA at mga estrukturang tinukoy sa pamamagitan ng computational methods. Kasama sa inilabas ang magkapares na datos sa pagsasanay, mga timbang ng modelo at source code, upang magkaroon ang ibang laboratoryo ng mga materyal para muling maisagawa ang pag-aaral at iangkop ang sistema.
Mga Nilalaman
- Isang modelong natututo sa mga titik ng RNA at sa mga ugnayan ng mga ito
- Bakit kasinghalaga ng sequence ang pagkatupi
- Paano binuo ang 21 milyong pares para sa pagsasanay
- Pagtuturo sa modelo gamit ang nakatagong impormasyon
- Mga natuklasan sa mga pagsusuri ng estruktura
- Mula sa pagproseso ng RNA hanggang sa pag-uuri ayon sa tungkulin
- Ano ang naibibigay ng bukas na release sa mga mananaliksik
- Ang pangkat at iskedyul ng paglalathala
- Ano ang pagbabago ng mga resulta para sa pananaliksik sa RNA
- Mahahalagang Punto
Inilathala ng Nature noong Nobyembre 4, 2026, inilalarawan ng pag-aaral ang isang modelong natututo kapwa sa pagkakasunod-sunod ng mga molecular building block ng RNA at sa mga ugnayang tumutulong sa pagkatupi ng mga molekulang ito. Sa adaptasyon nito para sa paghula ng mga three-dimensional na estruktura, na tinatawag na Zfold, nakamit ang pagganap na ayon sa mga may-akda ay maihahambing sa AlphaFold3 sa mga pagsusuri ng CASP15-natural, CASP16 at RNA-Puzzles.
Isa sa mga praktikal na pakinabang nito ay kailangan lamang ng structRFM ang isang sequence ng RNA bilang input matapos itong sanayin. Naglalabas ito ng impormasyong magagamit ng mga mananaliksik sa ilang gawain, kabilang ang paghula ng estruktura ng molekula, pagtukoy sa mga bahaging sangkot sa pagproseso ng RNA at pag-uuri sa mga molekula ng RNA ayon sa tungkulin.
Inilalahad sa papel-pananaliksik tungkol sa structRFM ng Nature ang gawaing ito bilang paraan upang magamit ang kaalaman sa estruktura sa iba't ibang gawain sa paghula. Kabilang sina Peng Xiong at S. Kevin Zhou sa mga kaukulang may-akda, at si Heqin Zhu ang unang may-akda.
Bakit kasinghalaga ng sequence ang pagkatupi
May papel ang RNA sa paggawa ng protina, regulasyon ng gene at pagproseso ng mga mensaheng henetiko. Ang sequence nito ay ang pagkakasunod-sunod ng mga nucleotide, mga yunit ng molekula na karaniwang kinakatawan ng mga titik na A, U, C at G. May dalang impormasyon ang pagkakasunod-sunod na ito, samantalang nakatutulong ang paraan ng pagtupi ng molekula upang matukoy kung paano ito gumagana.
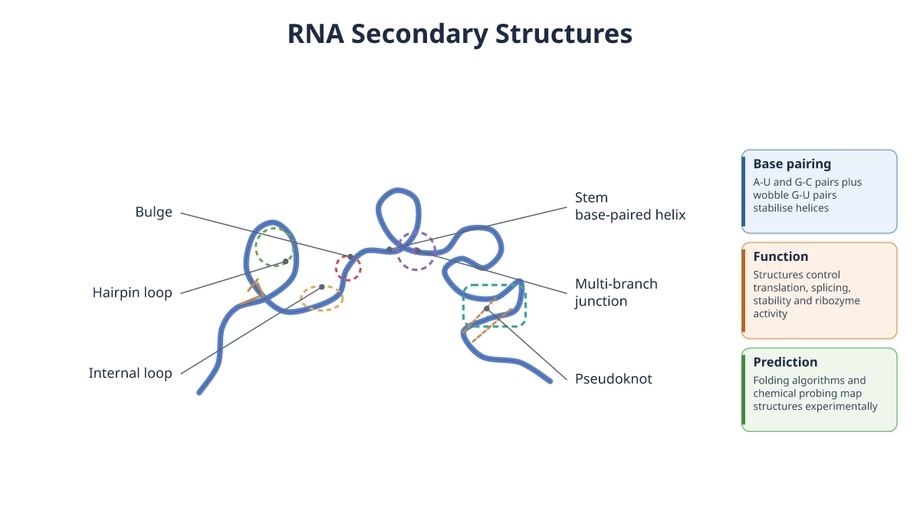
Maaaring magparesan ang mga bahagi ng isang hibla ng RNA sa iba pang bahagi ng parehong hibla. Lumilikha ang mga ugnayang ito ng sekundaryong estruktura, isang padron ng magkapares na rehiyon, tangkay at loop. Pagkatapos, tumutupi ang molekula sa isang three-dimensional na hugis, na kilala bilang tersiyaryong estruktura nito at nakaaapekto sa aktibidad at pakikipag-ugnayan nito sa ibang mga molekula.
Maraming language model para sa RNA ang natututo ng mga padron mula sa malalaking koleksiyon ng mga sequence, gaya ng pagkatuto ng language model sa mga ugnayan ng mga salita. Nagdaragdag ang structRFM ng impormasyon tungkol sa mga nucleotide na nagkakapares habang sinasanay ito, kaya natututuhan nito ang mga ugnayan ng mga posisyong maaaring magkakalayo sa sequence.
Hangad ng mga mananaliksik na mapanatili ang kakayahang umangkop ng isang foundation model: isang sistemang sinanay sa malawak na datos na maaaring iangkop ang mga natutuhan nitong feature sa iba't ibang layunin. Nais nilang maisama ang impormasyon tungkol sa pagkatupi sa pundasyong ito upang hindi lamang sa iisang gawaing estruktural magamit ang sistema.
Paano binuo ang 21 milyong pares para sa pagsasanay
Bumuo ang pangkat ng dataset na may humigit-kumulang 21 milyong pares ng sequence ng RNA at sekundaryong estruktura. Nilikha sa pamamagitan ng computational methods ang mga anotasyon sa estruktura, kaya nakapagsanay ang mga mananaliksik sa mas malaking antas kaysa kung koleksiyon lamang ng mga estrukturang natukoy sa mga eksperimento sa laboratoryo ang gagamitin.
Maaaring may mga pagkakamali ang mga hula ng computer at maaari ring maapektuhan ng mga kalakasan at kahinaan ng paraang ginamit sa pagbuo ng mga ito. Upang mabawasan ang pagdepende sa iisang tagahula, ipinakilala ng mga mananaliksik ang MUSES, isang pinagsamang sekundaryong estruktura mula sa maraming pinagmumulan. Pinagsasama ng ensemble ang impormasyon mula sa ilang pinagmumulan ng hula sa halip na umasa nang lubusan sa iisa.
Tinutugunan ng MUSES ang isang pangunahing suliranin sa pagsasanay ng mga modelo gamit ang mga hinulaang estruktura: maaaring mahubog ng paulit-ulit na mga pagkakamali sa mga anotasyon ng pagsasanay ang natututuhan ng modelo. Dinisenyo ang pagsasama-sama ng mga hula sa estruktura upang mabawasan ang pagkiling ng mga tagahula habang napapanatili ang kapaki-pakinabang na impormasyon tungkol sa pagpapares ng mga base.
Gumamit ang pagsasanay at pagsusuri sa pag-aaral ng mga kinikilalang koleksiyon sa biyolohiya, kabilang ang RNAcentral, Rfam at Protein Data Bank. Tinutukoy sa pahayag tungkol sa datos ang mga kaugnay na release, kabilang ang bersiyon 24.0 ng RNAcentral at mga bersiyong 14.10 at 15.0 ng Rfam, upang masubaybayan ng mga mananaliksik ang mga dataset na ginamit sa mga eksperimento.
Pagtuturo sa modelo gamit ang nakatagong impormasyon
Gumagamit ang structRFM ng masked language modelling, isang paraan ng pagsasanay kung saan itinatago ang ilang bahagi ng input at natututo ang modelo na tukuyin ang nawawalang impormasyon batay sa nakapaligid na konteksto. Para sa RNA, nangangahulugan ito ng pagkatuto sa mga ugnayan ng mga nucleotide sa halip na mga salita.
Isinama ng pangkat ang pagpapares ng mga base sa prosesong ito sa pamamagitan ng operasyong tinatawag na pair matching. Binabalanse ng dynamic masking ratio ang pagsasanay na ginagabayan ng mga ugnayang estruktural at ang pagtatago ng mga posisyon ng indibidwal na nucleotide. Nagbibigay ito sa modelo ng pagkakataong matutuhan kapwa ang mga lokal na padron ng sequence at ang mga ugnayang may kinalaman sa pagkatupi.
Nagbibigay ang nabuong modelo ng tatlong uri ng feature: impormasyon tungkol sa buong sequence, impormasyon tungkol sa bawat nucleotide at impormasyon tungkol sa mga pares ng nucleotide. Ang feature ay numerikal na representasyong magagamit ng ibang sistema sa paghula. Maaaring gumamit ang iba't ibang gawain ng magkakaibang antas ng representasyong ito.
Nagsagawa rin ang mga mananaliksik ng mga ablation experiment, kung saan inaalis o binabago ang mga bahagi ng modelo upang subukan ang ambag ng mga ito. Pinagtibay ng mga eksperimentong ito ang ambag ng impormasyon sa estruktura at ng estratehiya sa masking sa mga iniulat na pagbuti, at nagbigay ng ebidensiya para sa mga desisyong ginamit sa disenyo ng structRFM.
Mga natuklasan sa mga pagsusuri ng estruktura
Mahusay ang naging pagganap ng structRFM sa zero-shot homology classification. Tumutukoy ang homology sa mga ugnayang minana mula sa iisang ebolusyonaryong pinagmulan. Sa ganitong pagsusuri, sinusukat ng zero-shot classification kung gaano kapaki-pakinabang ang mga natutuhan nitong representasyon sa pagkilala sa gayong mga ugnayan nang hindi partikular na sinasanay para sa target na gawain ng pag-uuri.
Iniulat din ng mga may-akda ang pagbuti sa paghula ng sekundaryong estruktura at mahusay na pagganap sa mga bagong inilabas na pamilya ng RNA. Pinagsasama sa isang pamilya ng RNA ang magkakaugnay na mga molekulang may magkakatulad na katangian sa sequence o estruktura. Sinusubok ng mga bagong inilabas na pamilya kung gaano kahusay gumagana ang modelo lampas sa mga pamilyar na grupong nasa mga naitatag nang dataset.
Para sa paghula ng tersiyaryong estruktura, binuo ng pangkat ang Zfold sa pamamagitan ng pag-aangkop sa mga natutuhang feature ng structRFM para magamit sa isang modelong naghuhula ng mga three-dimensional na hugis. Iniulat ng mga may-akda ang pagbuti kapwa sa mga hinulaang hugis at sa mga sekundaryong estrukturang nakuha mula sa mga hulang iyon.
Sinuri ang Zfold gamit ang CASP15-natural, CASP16 at RNA-Puzzles, mga koleksiyon ng benchmark na ginagamit upang tasahin ang paghula ng estruktura ng molekula. Sa mga pagsusuring ito, inilalarawan sa papel ang pagganap nito bilang maihahambing sa AlphaFold3. Tumutukoy ang paghahambing sa mga resulta ng Zfold sa mga pinangalanang benchmark na iyon, samantalang ang structRFM ang nagbibigay ng mga saligang representasyon ng RNA.
Maraming uri ng tagumpay ang inilalahad sa pag-aaral sa halip na isang marka ng katumpakan na sumasaklaw sa lahat ng gamit. Magkakaibang suliranin ang pagkilala sa magkakaugnay na sequence, paghula sa magkakaparis na base at pagbubuo muli ng three-dimensional na hugis, at bawat isa ay nangangailangan ng sarili nitong pagsusuri.
Mula sa pagproseso ng RNA hanggang sa pag-uuri ayon sa tungkulin
Sinubukan din ang structRFM sa mga gawaing may kinalaman sa ginagawa ng RNA. Kabilang dito ang paghula sa splice site, pagtukoy sa internal ribosome entry site at pag-uuri sa non-coding RNA, kaya lumawak ang pagsusuri lampas sa hugis ng molekula.
Tumutukoy ang mga splice site sa mga hangganang ginagamit ng mga selula sa pagproseso ng mga mensahe ng RNA. Sa splicing, inaalis ang mga piling bahagi at pinagdurugtong ang natitirang mga seksiyon. Nakatutulong ang paghula sa mga hangganang ito sa mga mananaliksik na suriin kung paano binubuo ang isang mensaheng henetiko bago ito gamitin sa paggawa ng protina.
Ang mga internal ribosome entry site, o elementong IRES, ay mga rehiyon ng RNA na nagbibigay-daan sa makinarya ng selula na gumagawa ng mga protina na simulan ang pagsasalin ng mensahe sa loob mismo ng sequence. Kailangang makilala ang mga gumaganang padron sa loob ng sequence upang matukoy ang mga ito, kaya isa rin itong pagsubok sa impormasyong nakuha sa paunang pagsasanay.
May mga tungkuling iba sa pagiging hulmahan para sa paggawa ng protina ang mga non-coding RNA. Nangangahulugan ang pag-uuri sa mga ito ng pagtatalaga sa mga molekula sa mga kaugnay na grupo. Iniulat ng mga may-akda ang pagbuti ng pagganap sa mga gawaing ito na nakatuon sa tungkulin, na nagpapakita na nanatiling kapaki-pakinabang ang mga natutuhang representasyon nang lumipat ang target ng hula mula sa estruktura tungo sa biyolohikal na papel.
Inangkop din ng pangkat ang modelo para sa pag-uuri ng long non-coding RNA gamit ang estratehiya ng paghahati-hati. Sa paghahati ng mahabang sequence sa mga seksiyon, nagagamit ang modelo sa mga input na mahirap iproseso bilang iisang yunit.
Ano ang naibibigay ng bukas na release sa mga mananaliksik
Saklaw ng release ang tatlong mapagkukunan na may magkakaibang gamit. Nilalaman ng dataset ang mga halimbawang ginamit sa pagkatuto. Nasa mga timbang ng modelo ang mga numerikal na halagang natutuhan sa pagsasanay. Inilalarawan naman ng source code kung paano ipinatupad at pinatatakbo ang software.
Dahil makukuha ang mga timbang, maaaring gumamit ang mga mananaliksik ng sinanay nang modelo sa halip na ulitin ang buong proseso ng paunang pagsasanay. Sinusuportahan naman ng pagkuha sa datos at code ang masusing pagsusuri sa proseso ng pagsasanay, muling pagsasagawa ng mga eksperimento at pagbuo ng mga alternatibong pamamaraan.
Tinutukoy sa papel ang repositoryo ng proyekto bilang heqin-zhu/structRFM sa GitHub. Nakalista rin dito ang archive ng pretraining dataset sa Zenodo sa ilalim ng DOI 10.5281/zenodo.18272040 at archive ng source code at mga checkpoint ng modelo sa ilalim ng DOI 10.5281/zenodo.18274292. Ang DOI ay isang permanenteng identifier na nilayong makatulong upang masubaybayan sa paglipas ng panahon ang isang mapagkukunan sa pananaliksik.
Ayon sa pahayag tungkol sa datos, makukuha ng publiko sa repositoryo ng proyekto ang mga dataset sa pagsasanay at pagsusuri. Ibinibigay rin dito ang naprosesong IRES split na ginamit sa pag-aaral at ang pinagmulang datos para sa mga pigura. Ayon sa mga may-akda, walang ipinapataw na restriksiyon sa pagkakaroon ng datos.
Mahalaga ang mga detalyeng ito sa paghahambing. Maaaring siyasatin ng mga mananaliksik kung aling mga dataset at paghahati ng datos ang ginamit, ulitin ang mga pagsusuri at subukan kung magbabago ang mga resulta sa ibang pagpili ng paraan ng pagsasanay. Kaya nakatutulong ang release kapwa sa masusing pagsusuri sa mga natuklasan at sa muling paggamit ng modelo.
Ang pangkat at iskedyul ng paglalathala
Pinangunahan ang gawain sa School of Biomedical Engineering ng USTC at sa laboratoryong Medical Imaging, Robotics, Analytic Computing and Learning, na kilala bilang MIRACLE. Nakalista sa mga may-akda ang mga kaanibang institusyon sa Hefei at sa Suzhou Institute for Advanced Research ng USTC. Kaanib naman si Ruifeng Li, isang kapwa may-akda, sa College of Computer Science and Technology ng Zhejiang University sa Hangzhou.
Pinangunahan nina Zhou, isang propesor, at Xiong, isang special research fellow, ang pagbuo at pangangasiwa sa pag-aaral. Dinisenyo at ipinatupad ni Zhu ang balangkas, isinagawa ang paunang pagsasanay at ilang eksperimento sa paghula ng estruktura at pag-uuri ng RNA, at sinuri ang mga resulta. Nagtrabaho ang iba pang miyembro ng pangkat sa pagsusuri ng homology, paghahambing ng mga dataset, pagtukoy sa IRES at pagsusuri ng estruktura.
Naganap sa magkaibang petsa sa kalendaryo ang paglalathala at pampublikong pagpapakilala sa gawain:
- Nobyembre 4, 2026: Inilista ng Nature ang paglalathala ng An open structure-guided RNA foundation model for generalizable prediction.
- Nobyembre 5, 2026: Ipinahayag sa publiko sa China ang gawain at bukas na release nito, at iniulat na inilathala online ang papel sa madaling-araw.
Iniulat ng mga may-akda na sinuportahan ang gawain ng National Natural Science Foundation of China, National Key R&D Program, mga programa sa pananaliksik sa Jiangsu at Suzhou, at Sanming Project of Medicine sa Shenzhen. Ipinahayag nilang wala silang magkakatunggaling interes.
Ano ang pagbabago ng mga resulta para sa pananaliksik sa RNA
Nagbibigay ang structRFM ng iisang panimulang batayan para sa ilang gawaing pananaliksik. Maaaring iangkop ng laboratoryong nagsasaliksik sa pagproseso ng RNA ang mismong modelong ginagamit naman ng ibang pangkat sa pag-aaral ng pagkatupi o pag-uuri sa mga non-coding molecule. Nangangailangan pa rin ang bawat aplikasyon ng sarili nitong pagbuo at pagsusuri para sa partikular na gawain.
Sa pagsasama ng 21 milyong pares ng datos sa pagsasanay, pagkatutong ginagabayan ng estruktura at mga inilabas na checkpoint, nabibigyan ang mga mananaliksik ng kongkretong sistemang maaari nilang siyasatin sa halip na paglalarawan lamang ng isang algorithm. Nag-aalok din ang MUSES at mga eksperimento sa masking ng mga partikular na pagpili sa disenyo na maaaring subukan o baguhin ng ibang pangkat.
Nakasentro ang mga iniulat na natuklasan sa computational na paghula at pag-uuri. Mangangailangan ng karagdagang biyolohikal na eksperimento ang mga pagsisikap na gamitin ito sa biyomedisina, kabilang ang pagsuri sa mga hinulaang estruktura at pagsubok sa mga tungkuling iniugnay sa partikular na mga molekula ng RNA.
Walang itinakdang iskedyul sa papel para sa klinikal na aplikasyon. Ang agarang pagbabago ay ang pagkakaroon ng akses: maaaring kunin ng mga mananaliksik sa buong mundo ang mga mapagkukunan sa pagsasanay, siyasatin ang implementasyon at alamin kung magagamit din sa sarili nilang mga dataset ng RNA ang mga iniulat na pagbuti.
Mahahalagang Punto
- Inilabas ng mga mananaliksik ng USTC ang structRFM, isang foundation model para sa RNA na sinanay gamit ang humigit-kumulang 21 milyong pares ng sequence at sekundaryong estruktura.
- Natututo ang modelo ng mga padron sa sequence at ugnayan ng pagpapares ng mga base, at pagkatapos ay lumilikha ng mga feature gamit lamang ang sequence bilang input.
- Pinagsasama ng MUSES ang mga pinagmumulan ng hula sa estruktura, samantalang binabalanse ng dynamic masking ang impormasyon tungkol sa estruktura at mga nucleotide habang nagsasanay.
- Iniulat ng mga may-akda ang mahusay na pag-uuri ng homology at pagbuti sa paghula ng sekundaryong estruktura, kabilang ang mga pagsusuri sa mga bagong inilabas na pamilya ng RNA.
- Nakamit ng Zfold, ang adaptasyon nito para sa paghula ng tersiyaryong estruktura, ang pagganap na inilalarawang maihahambing sa AlphaFold3 sa tatlong pinangalanang koleksiyon ng benchmark.
- Makukuha ng publiko ang dataset, mga timbang ng modelo, source code at mga mapagkukunan sa pagsusuri upang magamit muli at muling maisagawa ang pananaliksik.