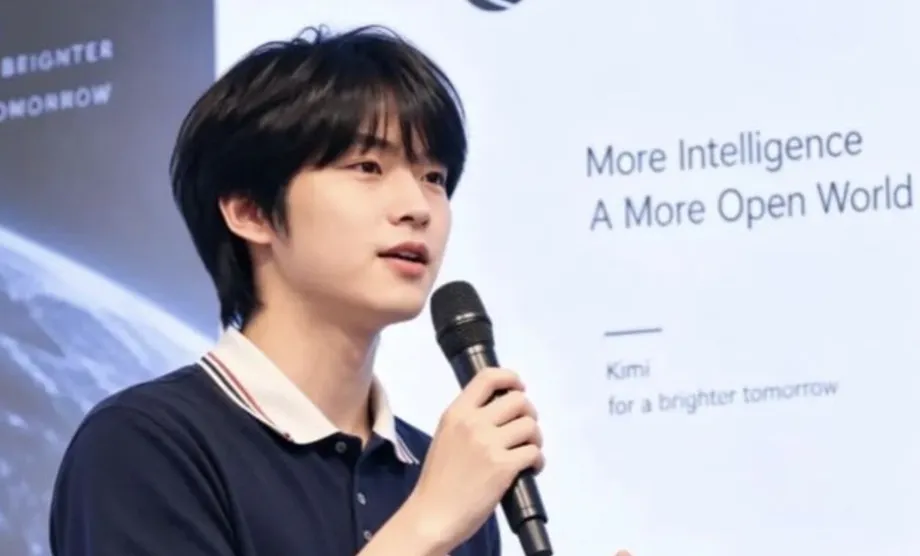
Umalis ang isang tinedyer na mananaliksik matapos tumulong sa muling pagdidisenyo ng Kimi
Ipinahayag ni Chen Guangyu, isang 17-anyos na mananaliksik na tumulong bumuo ng bagong paraan para magpasa ng impormasyon sa pagitan ng mga layer ng mga modelo ng artificial intelligence, noong Oktubre 15, 2026, na umalis na siya sa Moonshot AI, ang kumpanyang Tsino sa likod ng Kimi. Sumali siya sa pangkat ng pananaliksik nito noong Nobyembre 2025, noong 16 taong gulang siya.
Mga Nilalaman
- Umalis ang isang tinedyer na mananaliksik matapos tumulong sa muling pagdidisenyo ng Kimi
- Ambag ni Chen sa pananaliksik
- Mga pagbabagong hatid ng Attention Residuals sa modelo
- Mga ipinakikita ng mga inilathalang resulta
- Mula sa hackathon sa paaralan tungo sa pangkat ng pananaliksik
- Mga petsa sa likod ng mabilis na pag-angat
- Paanyaya ng Anthropic at ang usapin ng milyong dolyar
- Bakit napasama sa talakayan ang Discovery Loop
- Epekto ng pag-alis niya sa Moonshot
- Mahahalagang Punto
Kilala sa buong mundo bilang Nathan Chen, umalis ang tinedyer mula Shenzhen na may kongkretong ambag sa pananaliksik: kapantay na pangunahing pagkakakilala bilang may-akda ng Attention Residuals, isang papel na inilathala noong Marso 16, 2026, kasama ang mga mananaliksik ng Moonshot na sina Yu Zhang at Jianlin Su. Nang maglaon, naging bahagi ng Kimi K3 ang teknik, ayon sa mga ulat tungkol sa paglabas ng modelo noong Hulyo.
Mas tiyak na inilalarawan ng mga inilathalang eksperimento ng Moonshot ang gawain kaysa sa atensyong nakatuon sa edad niya. Sa mga pagsubok sa modelong Kimi Linear na may 48 bilyong parameter, nagtala ang mga mananaliksik ng mga pagbuti sa bawat sinuring gawain. Tumapat din ang kanilang pamamaraang Block Attention Residuals sa training loss ng isang karaniwang modelo na binigyan ng 1.25 ulit na mas malaking lakas-kompyutasyon.
Dahil sa pag-alis ni Chen, nagkaroon ng pampublikong paanyaya mula sa Anthropic, espekulasyon tungkol sa startup na itinatag ng mga dating mananaliksik ng Google, at mga pagtatangkang iugnay siya sa isang hindi pinangalanang tinedyer na iniulat na may limang alok na trabaho na nagkakahalaga ng humigit-kumulang $1 milyon o higit pa bawat isa.
Gayunman, hayagang itinanggi ni Chen ang pahiwatig na sasali siya sa Anthropic. Hindi pa kumpirmado kung sino ang susunod niyang employer, kung anong kompensasyon ang iaalok sa kanya, at kung babalik siya sa unibersidad.
Sa mensahe ng pamamaalam niya, inilarawan ni Chen ang panahong ginugol niya sa Moonshot at pinasalamatan ang mga kumuha sa kanya. Sinabi ng papaalis na intern sa pananaliksik ng machine learning:
Ang nakalipas na taon ang pinakamagandang taon ng buhay ko.
Nagtapos ang mensahe niya sa hangaring patuloy na magsiyasat, sa halip na tukuyin ang susunod na pupuntahan niya.
Ambag ni Chen sa pananaliksik
Nakalista ang pangalan ni Chen kasama nina Zhang at Su sa ilalim ng pagtatalagang pantay ang ambag sa ulat tungkol sa Attention Residuals ng pangkat ng Kimi. Kinikilala ng pagtatalagang ito na nanguna silang tatlo sa mga ambag sa mas malawak na pagsisikap ng pangkat.
Si Su, na kilala sa trabaho niya sa rotary position embeddings, o RoPE, ang nagsagawa ng mga unang eksperimento. Tinutulungan ng RoPE ang isang language model na matandaan kung saan lumilitaw ang mga salita o iba pang piraso ng impormasyon sa isang pagkakasunod-sunod. Si Zhang naman ang pangunahing may-akda ng pananaliksik sa arkitekturang Kimi Linear.
Kinilala ni Su sina Zhang at Chen sa pagtulong na gawing praktikal para sa malalaking modelo ang unang ideya ng Attention Residuals. Magkasama nilang iminungkahi ang Block AttnRes, isang bersyong idinisenyo para mapanatili ang mga pakinabang habang binabawasan ang pangangailangan sa memorya at komunikasyon kapag inilalapat ang pamamaraan sa malakihang antas.
Nagtrabaho rin si Chen sa pagpapabilis ng mga computing kernel para sa Kimi Delta Attention, o KDA. Ang kernel ay maliit na programang nagsasagawa ng partikular na kalkulasyon sa graphics processing unit. Kapag napahusay ito, mas mabilis matatapos ng parehong hardware ang isang gawain.
Saklaw ng trabaho niya ang dalawang magkaugnay na larangan: pagpapasya kung paano dapat buuin ang isang modelo at pagpapabilis sa mga kalkulasyong kailangan ng disenyong iyon. Para sa isang laboratoryong nagsasanay ng malalaking modelo, parehong nakaaapekto ang mga ito sa dami ng pananaliksik na maisasagawa gamit ang nakalaang badyet para sa kompyutasyon.
Mga pagbabagong hatid ng Attention Residuals sa modelo
Pinoproseso ng mga language model ang impormasyon sa maraming sunod-sunod na layer. Binabago ng bawat layer ang natatanggap nitong impormasyon at bumubuo ng mga representasyong gagamitin ng mga susunod na layer para hulaan ang sagot.
Pinananatili ng karaniwang residual connection na dumadaloy sa prosesong ito ang naunang impormasyon sa pamamagitan ng pagdaragdag sa mga output ng layer. Inilalarawan sa opisyal na repositoryo ng pananaliksik ng Moonshot ang isang suliranin sa paraang ito: habang lumalalim ang modelo, maaaring humina ang magkakahiwalay na ambag dahil sa paulit-ulit na pag-iipon, at lumaki ang sukat ng mga panloob na signal.
Pinapalitan ng Attention Residuals ang nakapirming pag-iipong ito ng prosesong natututuhan ng modelo sa pagpili ng impormasyon. Maaaring magtakda ang susunod na layer ng magkakaibang bigat sa impormasyong ginawa ng mga naunang layer, depende sa kasalukuyang input. Isipin ang isang mambabasang sumasangguni sa mga pinakakapaki-pakinabang na tala mula sa mga naunang kabanata sa halip na dalhin pasulong ang bawat tala na magkakapantay ang kahalagahan.
May kaakibat ding gastos ang hiwalay na pagpili mula sa bawat naunang layer. Pinagsasama-sama ng Block AttnRes ang mga layer, ginagamit ang karaniwang pagdaragdag sa loob ng bawat pangkat, at pumipili sa mga resultang representasyon ng mga pangkat. Ayon sa repositoryo, naibabalik ng humigit-kumulang walong pangkat ang karamihan sa pakinabang ng buong pamamaraan.
Gumamit ang pinakamalaking konfigurasyon ng Kimi Linear na inilalarawan sa papel ng 54 na layer, na pinangkat nang tig-aanim. Nagbigay ang siyam na pangkat, kasama ang paunang representasyon ng mga token, ng 10 mapagkukunan ng impormasyon na mapagpipilian. Ito ang praktikal na hakbang sa inhinyeriya na tumulong magdala sa ideya mula sa eksperimento tungo sa pagsasanay ng malalaking modelo.
Mga ipinakikita ng mga inilathalang resulta
Sinubukan sa papel noong Marso ang Attention Residuals sa modelong Kimi Linear na may kabuuang 48 bilyong parameter, kung saan 3 bilyon ang ina-activate habang nagpoproseso. Ang mga parameter ang natutuhang numerikal na setting sa loob ng isang modelo. Kapag bahagi lamang ng mga ito ang ina-activate, magagamit ng modelo ang malaking imbakan ng natutuhang kaalaman habang nililimitahan ang kalkulasyong kailangan sa bawat hakbang.
Gumamit ang pagsasanay ng 1.4 trilyong token, mga piraso ng teksto o iba pang datos na pinoproseso ng modelo. Hindi binago ng mga mananaliksik ang iba pang pangunahing bahagi ng arkitektura ng modelo, kaya naihambing nila ang pagdaragdag ng Attention Residuals sa batayang disenyo.
Sa GPQA-Diamond, isang pagsusulit sa mahihirap na tanong sa agham, tumaas ang iskor mula 36.9 tungo sa 44.4, o 7.5 puntos. Umakyat naman ang HumanEval, na sumusubok sa pagbuo ng code, mula 59.1 tungo sa 62.2. Tumaas ang MMLU, isang malawakang benchmark ng kaalaman, mula 73.5 tungo sa 74.6.
Mahalaga rin ang paghahambing sa kompyutasyon. Ang pagtapat sa batayang modelong gumagamit ng 1.25 ulit na mas malaking kompyutasyon ay nangangahulugang nakamit ang kaparehong iniulat na training loss gamit ang apat na ikalima ng badyet nito, o 20% na mas kaunting kompyutasyon. Sinusukat ng training loss kung gaano kalayo ang mga prediksiyon ng modelo sa mga target na sagot habang nagsasanay.
Hiwalay na inilarawan ng Moonshot ang ambag ng teknolohiya sa K3 bilang humigit-kumulang 25% na pagbuti sa kahusayan ng pagsasanay, na may dagdag na overhead na mas mababa sa 2%. Magkaibang konfigurasyon ng modelo ang tinutukoy ng mga eksperimento noong Marso at ng mga sumunod na pahayag tungkol sa K3; mula sa Kimi Linear ang detalyadong mga benchmark na binanggit sa itaas.
Mula sa hackathon sa paaralan tungo sa pangkat ng pananaliksik
Ipinanganak si Chen sa Shenzhen noong 2009. Bago sumali sa Moonshot, nag-organisa siya ng komunidad ng mga tinedyer na nagtatrabaho sa open source, gumawa ng mga software bot, at nagsaliksik ng sari-saring interes mula sa kaligtasan ng AI hanggang sa pisika.
Habang naghahanda ng mga aplikasyon sa unibersidad, itinigil muna niya ang ilang gawaing hindi niya kinagigiliwan at nagsimulang magbasa tungkol sa mga paksang interesado siya. Pinagsama sa sumunod niyang pagpasok sa pananaliksik ang sariling pag-aaral, pampublikong pagsulat tungkol sa teknolohiya, at pakikipag-ugnayan sa mga aktibong mananaliksik.
Noong Pebrero 2025, dumalo siya sa hackathon ng Moonshot AI para sa mga estudyante sa sekondarya kasama ang ThirdArm, isang proyektong nag-iisip ng dagdag na robotic na braso para tumulong. Doon niya nakilala si Dong Kehan, miyembro ng founding team ng MiraclePlus, na naghikayat sa kanya na ituon ang pansin sa makabagong teknolohiya.
Nakatanggap naman ng tugon mula sa mananaliksik na si Songlin Yang ang isang teknikal na post tungkol sa DeltaNet. Nakarating ang talakayan kay Ben Keigwin ng Tilde Research, isang startup sa Palo Alto, California, at nauwi ito sa pag-uusap tungkol sa trabaho ng kumpanya. Noong Hulyo 2025, mag-isang bumiyahe roon si Chen, na 16 anyos noon, para sa pitong linggong internship.
Kabilang sa paraan ng pag-aaral ni Chen ang paggugol ng maraming oras sa pakikipagtalakayan tungkol sa mga papel gamit ang Gemini, pagpapadala ng mga screenshot ng mahihirap na bahagi, at pagtatanong ng mga karagdagang tanong. Nagbasa rin siya ng code, mga blog at website ng mga mananaliksik, at humingi ng payo kay Yuan Jingyang, isang mananaliksik ng DeepSeek, tungkol sa mahahalagang pasiya.
Higit pa sa paggamit ng chatbot bilang tutor ang karanasan niya. Naging hayag sa publiko ang teknikal niyang pag-iisip sa pamamagitan ng mga isinulat niya, tumugon dito ang mga mananaliksik, at nagbigay ang mga internship ng pagkakataong maisagawa ang mga ideyang iyon sa pakikipagtulungan sa iba.
Mga petsa sa likod ng mabilis na pag-angat
Mula sa proyekto sa paaralan, nakarating si Chen sa isang internasyonal na internship at pagkatapos ay sa inilathalang pananaliksik tungkol sa modelo sa loob ng wala pang dalawang taon. Umalis siya matapos gamitin ang Attention Residuals sa isang malaking paglabas ng Kimi.
- Pebrero 2025: Lumahok si Chen sa hackathon ng Moonshot para sa mga estudyante sa sekondarya.
- Hulyo 2025: Sinimulan niya ang pitong linggong internship sa Tilde Research sa Palo Alto.
- Nobyembre 2025: Sumali siya sa pangkat ng Kimi ng Moonshot bilang intern sa pananaliksik ng machine learning sa edad na 16.
- Marso 16, 2026: Inilathala ang teknikal na ulat tungkol sa Attention Residuals, at pantay na kinilala sina Chen, Zhang at Su.
- Hunyo 2026: Nagtapos si Chen ng high school.
- Hulyo 2026: Inilunsad ang Kimi K3, na kabilang sa mga teknolohiyang arkitektural nito ang Attention Residuals.
- Oktubre 15, 2026: Ipinahayag ni Chen na umalis na siya sa Moonshot.
- Oktubre 16, 2026: Itinanggi niya ang espekulasyong sasali siya sa Anthropic.
- Oktubre 20, 2026: Inangkin ng isang hindi nagpapakilalang account na sasali siya sa Discovery Loop.
Nakalista rin sa pampublikong tala ng edukasyon niya ang pagpasok sa Carnegie Mellon University noong Agosto at Setyembre 2026. Naging bahagi ng espekulasyon kung trabaho o karagdagang pag-aaral ang susunod niyang hakbang ang maikling tala na ito.
Paanyaya ng Anthropic at ang usapin ng milyong dolyar
Nagkomento si Sholto Douglas, na namumuno sa scalable reinforcement learning sa Anthropic, sa post ng pamamaalam ni Chen. Tinanong niya kung balak pa rin ni Chen na pumasok sa Carnegie Mellon at inimbitahan niya itong magtulungan sa San Francisco.
Sumagot si Chen na papunta siya sa Bay Area. Nang magbunsod ng mga pahiwatig ang palitan na sumali siya sa Anthropic, maikli niya itong itinanggi:
hindi :)
Nagsimula nang hiwalay ang usapin tungkol sa suweldo. Inilarawan ng investor ng Menlo Ventures na si Deedy Das ang pakikipagkita sa isang hindi pinangalanang 17-anyos na naturuan ang sarili tungkol sa AI sa tulong ng mga language model, nag-intern nang humigit-kumulang isang taon sa isang nangungunang kumpanya ng AI, at umalis sa isang prestihiyosong undergraduate program sa Amerika pagkalipas ng dalawang linggo.
Ayon kay Das, may limang alok ang tinedyer mula sa mga nangungunang laboratoryo ng AI sa San Francisco, na nagkakahalaga ng humigit-kumulang $1 milyon o higit pa bawat isa. Ibinahagi rin ni Das na mas pinahahalagahan ng tinedyer ang pagkatuto kaysa pera.
Iniugnay ng mga gumagamit ng social media ang paglalarawang ito kay Chen dahil sa edad at kasaysayan niya sa pananaliksik. Hindi pinangalanan ni Das ang tinedyer, at hindi kinumpirma ni Chen na para sa kanya ang mga alok. Kaya nakasentro ang talakayan sa naiulat na mga alok ng isang hindi pinangalanang tao, hindi sa isang isiniwalat na kasunduan sa trabaho para kay Chen.
Mas kongkretong palatandaan ng interes ang pampublikong paanyaya ni Douglas: hayagang hinikayat ng isang nakatataas na mananaliksik si Chen na sumama sa kanya. Direktang sinagot din ng sumunod na pagtanggi ang espekulasyon tungkol sa Anthropic.
Bakit napasama sa talakayan ang Discovery Loop
Naging bagong sentro ng usapan ang Discovery Loop matapos sabihin ng Arfur Grok, isang hindi nagpapakilalang account na sumusubaybay sa paglilipat ng mga tauhan sa AI, noong Oktubre 20 na sumali na si Chen sa kumpanya. Hindi pa kinukumpirma ni Chen ang pagkakatalaga sa kanya, at tumangging magkomento ang startup tungkol sa mga usapin ng tauhan.
Itinatag ang kumpanya noong Agosto 2026 ng mga dating mananaliksik ng Google na sina Jeff Dean, Sanjay Ghemawat, Quoc Le at Oriol Vinyals. Layunin nitong gamitin ang AI para i-automate ang pananaliksik sa agham at machine learning, kabilang ang pagmumungkahi ng mga ideya, pagsasagawa ng mga eksperimento, at pagsusuri ng mga resulta.
Para sa isang mananaliksik na interesado sa mahusay na disenyo ng modelo, pamilyar na mga teknikal na suliranin ang kaakibat ng misyong ito. Kailangang mahusay gumamit ng mga mapagkukunan sa kompyutasyon ang mga sistemang nagpapatakbo ng maraming eksperimento sa pananaliksik, at makapagpaparami ng mga posibleng eksperimento sa loob ng takdang badyet ang mga pagpapahusay sa algorithm o kernel.
Napukaw rin ng pagpopondo sa Discovery Loop ang pansin. Iniulat na humingi ito ng pondo noong Setyembre batay sa halagang humigit-kumulang $50 bilyon, kumpara sa mga pag-uusap tungkol sa $10 bilyon ilang linggo bago nito, o limang ulit na pagtaas. Inilalarawan ng mga bilang na ito ang mga iminungkahing halaga ng kumpanya sa mga pag-uusap para makalikom ng pondo.
May ugnayan na rin si Chen sa Bay Area dahil sa Tilde Research. Nakakatulong ipaliwanag ang dati niyang internship doon kung bakit maaaring may ilang propesyonal na kakilala siya sa California, sa halip na iisang malinaw na pupuntahan.
Epekto ng pag-alis niya sa Moonshot
Sinabi ng mananaliksik ng Moonshot na si Du Yulun, na sumuporta sa pagkuha kay Chen noong 16 anyos siya, na ilang ulit silang nagkaroon ng mahahabang pag-uusap tungkol sa pasiya niyang umalis. Ipinahayag ni Du ang kalungkutan niya habang sinusuportahan ang kagustuhan ni Chen na magsaliksik ng mga bagong interes sa edad na ito.
Nananatili sa talaan ng pananaliksik ng pangkat ang mga ambag ni Chen. Pinagsama sa Kimi K3, na inilabas noong Hulyo na may 2.8 trilyong parameter, ang Attention Residuals at Kimi Delta Attention. Magkaibang bahagi ng pagproseso ng impormasyon ang tinutugunan ng mga ito: binabago ng AttnRes kung paano dumadaloy ang impormasyon sa lalim ng modelo, samantalang tumutulong ang KDA sa mahusay na pagproseso ng mga pagkakasunod-sunod.
Iniugnay ng Moonshot sa kabuuan ng mga pagbabagong arkitektural, pamamaraan ng pagsasanay at pagpili ng datos ang humigit-kumulang 2.5 ulit na pagbuti sa kahusayan ng pagpapalawak ng K3 kumpara sa K2. Bahagi lamang ng mas malawak na pagsisikap ng kumpanya, na kinasasangkutan ng maraming mananaliksik at ilang teknikal na pagbabago, ang trabaho ni Chen.
Higit pa sa karera ng isang di-pangkaraniwang batang empleyado ang praktikal na kahalagahan nito. Mas mahusay magagamit ng modelong mas mahusay matuto ang mamahaling mga processor at badyet sa pananaliksik. Direktang makatutulong sa layuning iyon ang isang mananaliksik na kayang iugnay ang matematikal na disenyo at mabilis na pagpapatupad.
Iniwan ni Chen ang Moonshot taglay ang nailathalang pananaliksik, karanasan sa dalawang kapaligiran ng pananaliksik, at interes mula sa isa pang nangungunang laboratoryo. Makabuluhan na ang kumpirmadong kuwento: tumulong ang isang tinedyer na gawing magagamit na pamamaraan ang isang ideyang arkitektural, saka nagpasyang magpatuloy sa pagtuklas bago ipahayag ang susunod niyang posisyon.
Mahahalagang Punto
- Ipinahayag ni Chen Guangyu, na kilala rin bilang Nathan Chen, ang pag-alis niya sa Moonshot AI noong Oktubre 15, 2026, sa edad na 17.
- Pantay ang pagkilala sa kanya bilang pangunahing may-akda kasama sina Yu Zhang at Jianlin Su sa Attention Residuals, na inilathala noong Marso 16.
- Nagpakita ang mga eksperimento ng Moonshot ng mga pagbuti sa lahat ng sinuring gawain at tumapat sa batayang modelong gumamit ng 1.25 ulit na mas malaking kompyutasyon.
- Tumulong si Chen sa pagbuo ng Block AttnRes at nagtrabaho sa pagpapabilis ng mga kalkulasyon ng Kimi Delta Attention.
- Sinabi niyang papunta siya sa Bay Area at itinanggi ang espekulasyong sasali siya sa Anthropic.
- Hindi pa kumpirmado ang sinasabing paglipat niya sa Discovery Loop at ang espekulasyong iniuugnay siya sa limang alok na nagkakahalaga ng humigit-kumulang $1 milyon bawat isa.