Bagong Pananaw sa Pagkontrol sa Laro
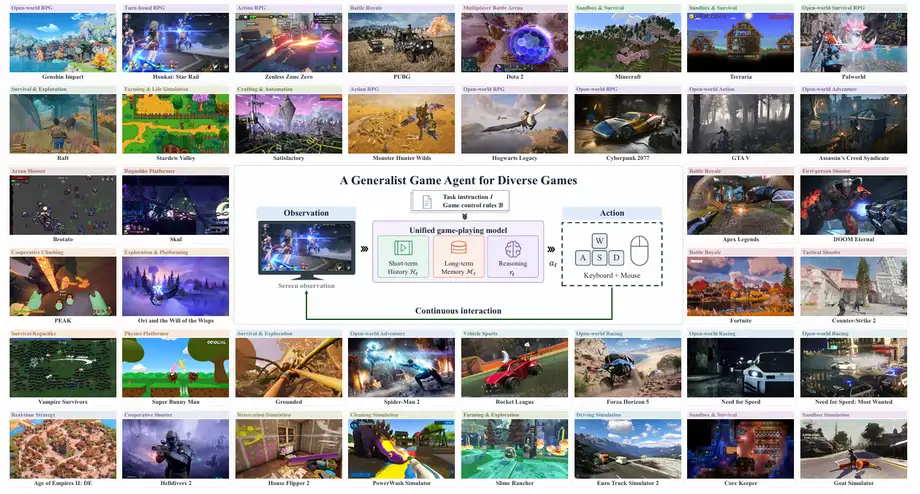
Mga mananaliksik sa miHoYo, na nagtatrabaho sa pamamagitan ng Honkai AI R&D team at sa pakikipagtulungan sa iba't ibang akademikong institusyon, ay inilunsad ang isang vision-language-action foundation model na pinangalanang Gamer. Lumihis ang proyekto mula sa mga tradisyonal na sistema na umaasa sa mga internal na game application programming interfaces o mga binagong memory states. Sa halip, pinoproseso ng framework ang hilaw na visual input mula sa mga screen ng laro at isinasalin nang direkta ang mga obserbasyong ito sa mga pamantayang utos ng keyboard at mouse. Detalyado ng development team ang underlying architecture sa isang preprint na may pamagat na Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent, na inilathala sa arXiv na may kasaysayan ng pagsusumite na nagsimula noong Nobyembre 13, 2026, at may huling rebisyon noong Nobyembre 18, 2026. Kabilang sa mga lumahok na pananaliksik na institusyon ang National University of Singapore, Tsinghua University, University of Chinese Academy of Sciences, University of Science and Technology of China, at Xi'an Jiaotong University. Kasama sa direksyon ng proyekto ang mga tanyag na personalidad tulad ni David Jiang, producer ng ilang malalaking titulo sa Honkai franchise, at Zheng Yinhe, pinuno ng technical team para sa artificial intelligence non-player character at gameplay ng Honkai series.
Mga Nilalaman
Hindi katulad ng mga tradisyonal na software agent na nangangailangan ng pribilehiyong access sa game code, nakikipag-ugnayan ang Gamer sa mga digital na kapaligiran nang tulad ng isang manlalarong tao. Kinukuha ng modelo ang mga screen frame sa dalas na limang hertz, ginagamit ang mga visual na signal na ito kasama ng mga utos na tagubilin at kasaysayan ng obserbasyon upang matukoy ang mga angkop na aksyon. Ang mga desisyong ito ay lumilitaw bilang isang serye ng mga mabababang antas na estado ng keyboard at galaw ng mouse na isinasagawa sa isang kontrol na ritmo na tatlumpung hertz. Sa pagtrato sa interaksyon ng user bilang isang ibinabahaging format na sumasaklaw sa mga tradisyonal na graphical interface at mga kumplikadong three-dimensional na simulated na mundo, nagbibigay ang framework ng isang pinag-isang diskarte sa digital na navigasyon at pag-execute.
Mga Training Pipeline at Multi-Stage na Pag-aaral
Ang pagbuo ng isang autonomous agent na may kakayahang sustentuhin ang mahabang gameplay ay nangangailangan ng paglampas sa pamantayang multimodal instruction tuning. Isinagawa ng research team ang isang komprehensibong training pipeline na nahahati sa tatlong natatanging yugto. Ang paunang yugto ay nagsasama ng patuloy na pretraining sa isang malaking dataset na binubuo ng libu-libong oras ng device-level na keyboard at mouse interaction trajectory. Sakop ng mga record ng interaksyong ito ang mga simulated na laro at embodied na kapaligiran, na nagpapahintulot sa modelo na matuto ng mga dynamika ng kapaligiran at mga visual-motor na correlation sa magkakaibang digital na setting. Ayon sa dokumentasyon ng proyekto, isinama sa training data ang mga interaction trajectory mula sa mga pinagkukunan tulad ng VPT, D2E, OpenP2P, at mga nakuha na footage mula sa Honkai: Star Rail.
Pagkatapos ng patuloy na pretraining, sumasailalim ang modelo sa sparse-reasoning instruction tuning. Sa yugtong ito, natututo ang framework na balansehin ang agarang motor execution at ang sinadyang pagpaplano. Sa halip na gumawa ng tuloy-tuloy na paliwanag na teksto para sa bawat frame, direktang isinasagawa ng modelo ang mga karaniwang galaw habang inilalaan ang mga malinaw na reasoning block para sa mga pangunahing decision point, tulad ng mga sequence sa paglutas ng puzzle o mga pilihan sa naratibo. Ang huling yugto ng pagsasanay ay nagpapakilala ng isang online reinforcement learning method na kilala bilang Temporal-Aware Group Relative Policy Optimization. Tinutugunan ng teknik na ito ang mga hamon ng mga limitadong context window, mga naipong rollout error sa mahahabang sequence ng gawain, at mga sparse reward sa pamamagitan ng pag-uugnay ng mga segment ng trajectory sa pamamagitan ng mga persistent na memory summary.
Pamamahala ng Memory at Mahabang Execution
Ang pag-execute ng mga gawain na umaabot ng ilang oras ng gameplay ay nagpapakita ng malalaking balakid na may kinalaman sa pagpapanatili ng memory at mga limitasyon ng context. Kapag nag-e-explore ang isang agent sa malalaking virtual na mundo, mabilis na naglalaho ang mga maagang interaksyon mula sa aktibong context window, na nagdudulot ng mga error sa navigasyon o mga nakalimutang layunin. Upang mapanatili ang progreso ng gawain nang hindi nag-o-overload sa sistema ng mga walang-hanging lumalagong kasaysayan ng pag-uusap, isinama ng mga mananaliksik ang isang persistent na memory mechanism. Habang umuusad ang mga gawain at lumalabas ang mga mas lumang interaksyon sa aktibong context, bumubuo ang modelo ng mga compact na summary na nagtatala ng mga nakamit na milestone, mga nabigong pagtatangka, mga mahahalagang lokasyon, at mga susunod na plano.
Ang bisa ng multi-stage na pagsasanay at diskarte sa pamamahala ng memory na ito ay sinuri sa pamamagitan ng masusing pagsubok sa tiyak na mga role-playing na scenario. Sa mga sinuring side quest sa Honkai: Star Rail, ang mga rate ng pagkakamit ng milestone ay nagpakita ng matatag na pagpapabuti sa mga yugto ng pagsasanay. Para sa side quest na pamagat ay Opportunity Makes the Thief (Part I), tumaas ang milestone completion rate mula sa 34.4% kasunod ng patuloy na pretraining tungo sa 72.2% pagkatapos ng supervised fine-tuning, at umabot sa 80.0% sa paglalaman ng online reinforcement learning. Katulad na paraan, para sa side quest na Bestial Ferocity, umusad ang completion rate mula 47.9% tungo sa 69.1%, at sa huli ay umabot sa 83.6% kasunod ng reinforcement learning optimization. Sa isang sinuring set ng apatnapung pamilyar na mini-game na gawain, ang isang bersyong itinakda bilang Gamer-RL ay nakapagtala ng average na tagumpay na 49.7%.
Real-Time Inference at Streaming Architecture
Ang pagpapanatili ng mataas na performance habang nagaganap ang real-time na interaksyon ay nangangailangan na manatiling mahigpit sa loob ng mga tolerance threshold ng interactive software ang inference latency. Upang maiwasan ang mga pagkaantala na magpapalabas sa isang agent na makaligtaan ang mga dynamic na kaganapan sa mabilis na kapaligiran, dinisenyo ng development team ang isang cloud-edge serving system na tinatawag na Streaming-vLLM. Pinagsasama ng inference engine na ito ang persistent na paggamit muli ng context, beripikadong speculative decoding, at maagang pagpapadala ng aksyon upang maayos na maproseso ang mga parallel na rollout. Iniiwasan ng persistent na paggamit muli ng context ang mga redundant na kalkulasyon sa mga nakaraang estado ng screen sa pamamagitan ng pagpapanatili ng mga key-value cache sa mga frame, habang ang maagang pagpapadala ng aksyon ay nagpapadala ng unang bisa ng grupo ng mga utos ng keyboard sa game client bago pa matapos bumuo ang mga susunod na token.
Ipinaliliwanag ng mga performance benchmark na nakadokumento sa repository ng proyekto ang epekto ng mga optimized na ito. Sa pagpapatakbo sa isang kapaligiran na kagamitan ng NVIDIA H200 hardware at sa paggamit ng isang model configuration na batay sa Qwen3.5-35B-A3B na may tensor parallelism na nakatakda sa apat, nakapagtala ang baseline setup ng end-to-end na request latency na 1,306.00 millisecond. Kasunod ng paglalaman ng mga Streaming-vLLM optimization, bumaba ang request latency na iyon sa 65.12 millisecond. Ang pagbawas sa oras ng execution na ito ay nagbibigay-daan sa sistema na suportahan ang mga concurrent na online evaluation at mapanatili ang mga reaktibong control loop habang nagaganap ang mga kumplikadong spatial navigation at combat sequence.
Saklaw ng Pananaliksik at Praktikal na mga Limitasyon
Ang paglabas ng research framework na ito ay nakapagbukas ng malawakang usapan tungkol sa potensyal nitong kakayahan at sa mga inilaan na aplikasyon. Binibigyang-diin ng dokumentasyon ng proyekto at ng mga pahayag ng publiko ng research team na ang Gamer ay isang akademikong exploration project na dinisenyo upang pag-aralan ang pag-uugali ng generalist agent sa mga interactive na kapaligiran, at hindi isang awtorisadong commercial tool para sa awtomasyon ng mga player account o paglikha ng competitive advantage. Upang tugunan ang mga alalahanin sa seguridad ng data, itinago ng team ang tiyak na training data at model weights na may kinalaman sa mga proprietary na titulo, at tanging mga foundational na pretraining file at system documentation lang ang inilagay sa pampublikong access sa mga resource tulad ng Gamer GitHub repository.
Ang mga potensyal na praktikal na aplikasyon na inilista ng mga developer ay nakatuon pangunahin sa pang-industriya at pang-unlad na kapaki-pakinabang kaysa sa consumer automation. Maaaring gamitin ng mga automated testing pipeline ang gayunding modelo upang magsagawa ng stress testing sa mga nagbabagang narrative path at malawak na virtual na mundo, at matukoy ang mga depekto sa implementasyon nang mas mabilis kaysa sa mga tradisyonal na manu-mano na paraan ng beripikasyon. Bukod dito, nagbibigay ng mga pananaw ang mga underlying na prinsipyo tungkol sa accessibility assistance at pananaliksik sa human-computer interaction, na binubuksan ang daan para sa mga agent na may kakayahang isalin ang magkakaibang input modality tumpak na digital na aksyon.
Mga Mahahalagang Punto
- Ang research framework ay binuo ng Honkai AI R&D team sa miHoYo pakikipagtulungan sa mga akademikong institusyon kabilang ang National University of Singapore at Tsinghua University.
- Ang mga detalyadong natuklasan at paglalarawan ng arkitektura ay nakadokumento sa preprint na Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent.
- Kinukuha ng sistema ang mga hilaw na obserbasyon sa screen sa limang hertz at nagbubukas ng mga native na utos ng keyboard at mouse nang hindi nangangailangan ng mga internal na application programming interface o memory hook.
- Kasama sa mga pamamaraan sa pagsasanay ang patuloy na pretraining sa libu-libong oras ng interaction trajectory, sparse-reasoning instruction tuning, at Temporal-Aware Group Relative Policy Optimization.
- Ang custom na inference engine, Streaming-vLLM, ay nagbawas ng request latency mula 1,306.00 millisecond tungo sa 65.12 millisecond sa mga pagsubok na gumagamit ng NVIDIA H200 hardware.
- Iginigiit ng research team na ang proyekto ay nagsisilbing isang akademikong pag-aaral na nakatuon sa mga aplikasyon tulad ng automated testing at accessibility research, at hindi isang commercial tool para sa awtomasyon ng gameplay.