Itinatampok ng Samsung ang kapasidad ng memory kasabay ng bilis ng pagproseso
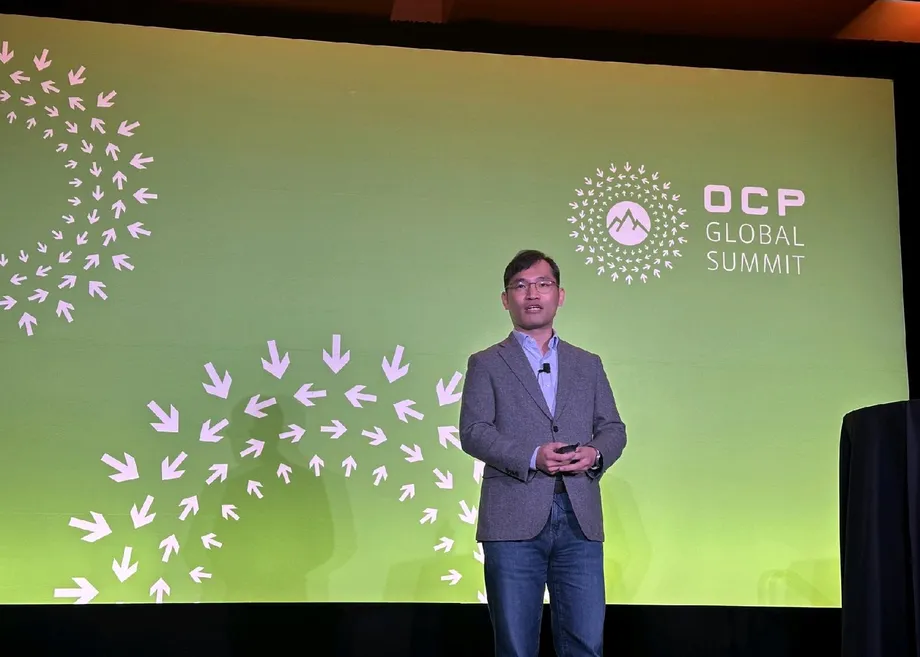
Pinalalawak ng Samsung Electronics ang estratehiya nito sa imprastraktura ng AI lampas sa high bandwidth memory. Pinagsasama nito ang HBM5 at customized memory sa pakikipagtulungan sa AMD tungkol sa shared server memory at mga teknolohiya sa storage na naglilipat ng ilang pagproseso ng datos sa mga SSD. Inilahad ng kumpanya ang paraang ito sa OCP Global Summit 2026, na nakatakda mula Oktubre 12 hanggang 15 sa San Jose McEnery Convention Center sa California.
Mga Nilalaman
- Itinatampok ng Samsung ang kapasidad ng memory kasabay ng bilis ng pagproseso
- HBM5 ang nangunguna sa mas malawak na estratehiya sa bilis
- Layunin ng pakikipagtulungan sa AMD na gawing mas nababagay ang kapasidad ng memory
- Iniuugnay ng KV cache ang pagpapalawak ng memory sa storage
- Ginagamit ang mga SSD para sa kapasidad, pagpapalamig at paglalagay ng datos
- Inilalapit ang pagproseso sa nakaimbak na datos
- Pinalalawak ng mga pagsubok kasama ang customer at mga eksibit ng foundry ang alok
- Pakikipagtulungang umunlad sa loob ng ilang buwan
- Hindi pinatutunayan ng laki ng merkado ang kahandaang magkomersiyal
- Mahahalagang Punto
Ang pinakakongkretong pahayag nito tungkol sa performance ay may kinalaman sa iba pang bahagi ng memory hierarchy. Iniulat ng Samsung na hanggang 38% na mas maikli ang paghihintay bago makabuo ng unang token ang isang AI model sa pamamagitan ng elastic CXL memory allocation, hanggang tatlong ulit ang performance ng inference sa LPDDR5X processing in memory, at umaabot sa 28.4 GB/s ang sunud-sunod na pagbasa ng SSD. Mga resulta ito ng partikular na pagsusuri o demonstrasyon, hindi mga garantiyang maaasahan sa lahat ng instalasyon ng AI.
Inilalatag ng opisyal na pahina ng summit ng Samsung ang estratehiya nito batay sa bilis, pagpapalawak ng memory at pagpapanatili ng datos. Kabilang sa mga tampok nitong produkto ang HBM4E, LPDDR5X-PIM, CMM-D MD310 memory module, SOCAMM2 server memory, at mga PM1763 at BM1773 SSD.
Nakatakdang ilahad ni Hojun Shim, na kinilala ng Samsung bilang corporate vice president at pinuno ng Memory Business Application Engineering Team, ang tatlong prayoridad sa isang executive session noong Oktubre 12. Inilalarawan ng mga ulat ang presentasyon bilang paglulunsad ng mas malawak na pagsisikap na i-optimize nang magkakasama ang mga processor, memory at storage, sa halip na paghusayin ang bawat bahagi nang magkakahiwalay.
Mahalaga ang pagkakaibang ito sa inference, kung kailan bumubuo ng mga sagot ang isang sinanay na modelo. Maaari pa ring maghintay ang isang mabilis na accelerator habang kinukuha ang datos, kapusin sa memory habang humahaba ang mga pag-uusap, o maantala sa pagkuha ng impormasyon mula sa storage. Nagmumungkahi ang Samsung ng magkakaibang teknolohiya para sa bawat limitasyong ito.
HBM5 ang nangunguna sa mas malawak na estratehiya sa bilis
Kabilang sa mga hakbang ng Samsung para pabilisin ang pagproseso, ayon sa mga ulat tungkol sa eksibisyon, ang HBM5 na inilalarawan bilang ikawalong henerasyon ng high bandwidth memory, customized HBM at zHBM. Nagbibigay ang high bandwidth memory ng maraming datos sa accelerator sa pamamagitan ng maraming magkakaparehong koneksiyon. Layunin naman ng mga customized na bersiyon na tumugma sa mga pangangailangan ng sistema ng bawat customer.
Hinihirang ng opisyal na listahan ng produkto ang HBM4E sa halip na HBM5. Inilalarawan naman ng ibang ulat na may mga mockup ng konsepto ng HBM4E at HBM5 sa eksibisyon. Mahalaga ang pagkakaibang ito: hindi patunay ng aktuwal na pagpapadala ng produkto ang pagpapakita nito o presentasyon ng konsepto, at walang ibinigay na petsa ng komersiyal na paglabas ng HBM5 o detalyadong espesipikasyon ng performance sa pahina ng summit ng Samsung.
Nagmumula sa LPDDR5X-PIM ang pinakamatibay na numerikal na ebidensiya tungkol sa bilis ng pagproseso. Inilalagay ng processing in memory ang ilang kalkulasyon sa loob mismo ng memory device, kaya nababawasan ang paulit-ulit na paglilipat ng datos sa pagitan ng memory at hiwalay na processor. Ayon sa Samsung, isinasama ng disenyo nito ang mga processing unit sa bawat memory bank.
Sa isang pagsusuring gumamit ng Llama 3.1 8B sa Samsung Edge AI Accelerator, iniulat ng Samsung na hanggang walong ulit ang epektibong bandwidth kumpara sa karaniwang LPDDR5X, hanggang tatlong ulit ang mga token na nalilikha bawat segundo, at hanggang 2.2 ulit na mas maikli ang runtime. Tumutukoy ang mga bilang na ito sa accelerator at modelong iyon, hindi sa HBM5 o sa demonstrasyon ng memory kasama ang AMD.
Itinatampok din ang SOCAMM2, isang server memory module na batay sa LPDDR. Ipinapakita ng mga eksibit na saklaw ng estratehiya ng Samsung sa bilis kapwa ang accelerator memory at mga teknolohiyang memory na mas matipid sa kuryente, bagaman walang maihahambing na resulta ng benchmark para sa bawat produkto sa pahina ng summit.
Layunin ng pakikipagtulungan sa AMD na gawing mas nababagay ang kapasidad ng memory
Nagpakita ang Samsung at AMD ng CXL memory expansion gamit ang teknolohiyang CMM-D ng Samsung. Ang CXL, daglat ng Compute Express Link, ay nag-uugnay sa mga processor at iba pang device sa karagdagang memory. Dahil dito, maaaring palawakin ng mga sistema ang kapasidad nang lampas sa memory na direktang nakakabit sa mga ito.
Ang CMM-D ay DRAM memory module na batay sa CXL. Sa pooled na konfigurasyon, maaaring kumuha ng kapasidad ang maraming sistema mula sa magkakaugnay na memory resource sa halip na permanenteng italaga ang kapasidad na iyon sa mga indibidwal na server. Ayon sa Samsung, pinatunayan ng pakikipagtulungan nito sa AMD na maaaring gamitin ang CXL upang palakihin ang kapasidad at bandwidth ng memory habang binabawasan ang mga panahong naghihintay ng datos ang mga CPU core.
Lalong nagiging mahalaga ang problemang ito habang nagpapatakbo ang mga AI agent ng maraming modelo o gawain. Ayon sa opisyal na paglalarawan ng Samsung, maaaring lubhang tumaas ang paggamit ng CPU sa mga workload ng agent habang hindi nakasasabay ang kapasidad ng memory sa dami ng processor core.
Gumamit naman ang hiwalay na demonstrasyon ng CMM-D pooling ng elastic allocation sa maraming large language model instance sa isang GPU server. Iniulat ng Samsung na hanggang 38% na mas mababa ang oras bago lumabas ang unang token, o TTFT, at hanggang 3.3 ulit na mas mataas ang goodput kumpara sa static allocation. Sinusukat ng TTFT ang tagal ng paghihintay bago magsimula ang tugon; sinusukat naman ng goodput ang kapaki-pakinabang na gawaing naihahatid ayon sa pamantayan ng pagsusuri.
Hindi dapat ituring ang mga resultang ito bilang mga numerikal na resulta mismo ng demonstrasyon kasama ang AMD. Magkahiwalay na inilalarawan sa opisyal na pahina ang pagpapatunay kasama ang AMD at ang benchmark ng elastic allocation. Wala rin itong sapat na detalye upang matukoy kung paano magbabago ang mga pakinabang sa iba’t ibang modelo, konfigurasyon ng server o target ng serbisyo.
Iniuugnay ng KV cache ang pagpapalawak ng memory sa storage
Isang mahalagang ugnayan sa pagitan ng mga plano ng Samsung sa memory at storage ang key value cache, na karaniwang tinatawag na KV cache. Naglalaman ito ng pansamantalang impormasyong nalilikha habang pinoproseso ng language model ang teksto, kaya magagamit muli ng modelo ang nagawa na sa halip na ulitin ang kalkulasyon para sa bawat bagong token.
Maaaring kumonsumo ng malaking kapasidad ng memory ang mga cache na ito kapag mahahaba ang mga pag-uusap, malalaki ang context o maraming user ang sabay-sabay na gumagamit. Iminumungkahi ng Samsung ang isang tiered na sistema kung saan pinalalawak ng CXL memory ang magagamit na kapasidad at iniimbak ng mga SSD ang cache data na hindi kailangang manatili sa pinakamabilis na antas ng memory.
Inilalarawan sa opisyal na pahina ng summit ang isang production deployment sa campus ng Samsung Semiconductor sa US na nagpapatakbo ng internal AI coding agent at iba pang aplikasyon. Ayon sa Samsung, naghatid ng lima hanggang pitong ulit na paggamit ng KV cache ang pagdaragdag ng L3.5 composable memory tier sa pamamagitan ng solusyong AI Memory Node nito.
Ang L3.5 ang katawagang ginagamit para sa karagdagang tier na iyon, hindi pahayag na magkakapareho ang cache architecture ng lahat ng server. Kabilang sa deployment ang Memory Solutions Lab ng Samsung, ang DSA AI Platform Integrations team nito at ang SGLang. Iba ang resulta sa paggamit ng memory na ito sa benchmark ng elastic allocation at sa mga bilang ng performance ng LPDDR5X-PIM.
Kasama rin sa iskedyul ng summit ang sesyon noong Oktubre 13 tungkol sa pagsasama ng CXL pooling at SSD storage para ilipat ang KV cache, na iniharap ng system architect na si Jinin So at principal engineer na si Youngha Choi. Higit pa ito sa simpleng pagpapataas ng kapasidad: kailangan ng software na maglagay at kumuha ng datos sa memory at storage nang hindi nagdudulot ng labis na pagkaantala.
Ginagamit ang mga SSD para sa kapasidad, pagpapalamig at paglalagay ng datos
Nakasentro sa mga enterprise SSD at high capacity NAND flash ang estratehiya ng Samsung sa pagpapanatili ng datos. Nangangahulugan ang persistence na nananatili ang datos lampas sa pansamantalang takbo ng kalkulasyon, para makuha ng mga AI system kung kinakailangan ang mga dataset, model file at nakaimbak na impormasyon ng cache.
Inilalarawan ang PM1763 bilang PCIe Gen6 enterprise SSD na may sunud-sunod na bilis sa pagbasa na hanggang 28.4 GB/s at power efficiency na hanggang 1.8 ulit kumpara sa naunang modelo. Sa demonstrasyon ng liquid cooling ng Samsung, direktang idinidikit ang bersiyong E1.S sa cold plate upang alisin ang init. Walang kumpletong hanay ng mga kondisyon sa pagsusuri para sa paghahambing ng performance sa opisyal na pahina.
Nakalista ang BM1773 bilang E3.S SSD na may 256TB na QLC storage. Nag-iimbak ang QLC, o quad level cell, ng apat na bit sa bawat flash cell, kaya sumusuporta ito sa malaking kapasidad. Inilalarawan din ng mga ulat ang patuloy na pagbuo ng Samsung ng high capacity QLC flash at teknolohiya para sa flexible na paglalagay ng datos.
Nagpakita ang Samsung ng mga pag-optimize sa KV cache na isinama sa LMCache. Tinutulungan ng Flexible Data Placement, o FDP, na ayusin kung saan isinusulat ang datos upang mabawasan ang write amplification, o ang karagdagang panloob na pagsusulat ng SSD lampas sa datos na ipinadala ng host.
Gumagamit din ang demonstrasyon ng mas malaking NVMe Maximum Data Transfer Size upang bawasan ang gawain ng host CPU. Ayon sa Samsung, mahalaga ang mga paraang ito kapwa sa pag-iimbak ng cache sa loob ng iisang node at sa pagbabahagi ng mga mapagkukunan ng cache sa isang pangkat ng mga server. Walang numerikal na resulta para sa mga partikular na pag-optimize na ito sa pahina ng kaganapan.
Inilalapit ang pagproseso sa nakaimbak na datos
Nag-aalok ang demonstrasyon ng vector database ng Samsung ng isa pang paraan upang mabawasan ang paglilipat ng datos. Nag-iimbak ang mga vector database ng mga numerikal na representasyon ng impormasyon at inihahambing ang mga ito upang makahanap ng magkakatulad na item. Karaniwan itong hakbang kapag kumukuha ang AI application ng mga dokumentong may kaugnayan sa isang kahilingan.
Inililipat ng proof of concept ng NCVS sa mga SSD ang pagkalkula ng distansiya ng mga vector. Sa halip na magpadala ng 4KB vector sa host para ihambing, ibinabalik ng device ang resulta ng distansiyang may sukat na apat na byte. Iniulat ng Samsung na hanggang 22 ulit na mas mababa ang trapiko ng host kumpara sa karaniwang paraan ng pagproseso sa host, at tumataas ang throughput ng paghahanap habang dumarami ang idinadagdag na SSD.
Inilalarawan ng mga bilang na apat na byte at 4KB ang laki ng mga indibidwal na resulta at vector; hindi ibig sabihin ng mga ito na bababa nang kaparehong antas ang trapiko ng buong aplikasyon. Ang iniulat na hanggang 22 ulit na pagbaba ay tumutukoy sa mas malawak na paghahambing na sinukat. Tinutukoy ng Samsung ang NCVS bilang proof of concept, hindi bilang produktong pangkalahatang mabibili.
Tinutugunan naman ng demonstrasyong AiSIO nito ang input at output ng storage sa pamamagitan ng iisang software interface para sa mga operasyong sinisimulan ng GPU, peer-to-peer at karaniwang sinisimulan ng CPU. Iniulat ng Samsung ang 100 milyong input/output operation bawat segundo at hanggang sampung ulit na mas mabilis na pag-load ng mga language model mula sa malamig na pagsisimula gamit ang OpenDS.
Magkakaibang gawain ang inilalarawan ng mga sukat na ito. Tumutukoy ang sunud-sunod na bilis ng pagbasa sa tuluy-tuloy na paglilipat ng datos, binibilang ng input/output operation bawat segundo ang mga kahilingan sa storage, at sinusukat ng pag-load mula sa malamig na pagsisimula kung gaano kabilis maging handa ang isang modelo. Walang isa man sa mga ito ang direktang kapalit ng benchmark na nagpapakita kung ilang kahilingan ng user ang kayang asikasuhin ng isang buong serbisyo ng AI.
Pinalalawak ng mga pagsubok kasama ang customer at mga eksibit ng foundry ang alok
Layunin ng Samsung MAX Lab na mas maagang maisali ang mga customer sa pagbuo ng produkto. Maaaring subukan ng mga customer ang mga teknolohiya tulad ng PIM, CMM-D at mga susunod na henerasyong SSD bago ang komersiyalisasyon sa makatotohanang mga AI workload, at gamitin ang mga pangangailangan ng sistema upang gabayan ang disenyo ng produkto.
Tinutugunan ng paraang ito ang praktikal na usaping lumilitaw sa mga demonstrasyon sa summit: may pakinabang lamang ang mas mabilis na bahagi kung magagamit ito ng software at ng nakapaligid na hardware. Nakikilahok ang Global Open-ecoSystem Team ng Samsung sa open source development at pagtatakda ng mga pamantayan sa industriya, habang kabilang sa programa ng kaganapan ang mga sesyon tungkol sa software framework, pangangasiwa sa mga utos ng storage at pamamahala ng memory.
Nagpakita rin ang Samsung ng composable storage na may live migration at pamamahala ng virtual SSD sa karaniwang NVMe. Inilalarawan ito ng opisyal na paliwanag bilang paraan upang maibahagi ang storage sa maraming tenant at maipatupad ang quality of service, o mga kontrol sa serbisyong natatanggap ng bawat workload.
Lampas sa memory ang saklaw ng eksibisyon. Inilalarawan ng mga ulat ang mga wafer ng Groq language processing unit na ginawa sa 4nm process ng Samsung Foundry, isang sistemang Groq 3 LPX na inilalarawan sa ilang ulat bilang sistema ng Nvidia, at mga wafer na gumagamit ng 2nm gate all around process ng Samsung. Ipinakikita ng mga eksibit na ito ang mga kakayahan sa pagmamanupaktura kasabay ng memory at storage, ngunit hindi pinatutunayan ng mga ito ang mga bagong kontrata sa produksyon o dami ng ipadadalang produkto.
Pakikipagtulungang umunlad sa loob ng ilang buwan
Kasunod ng naunang kooperasyon ang demonstrasyon kasama ang AMD at hindi ito nag-iisa. Inilalarawan ng mga ulat ang isang memorandum of understanding noong Marso na sumasaklaw sa mga susunod na henerasyong teknolohiya ng AI memory at computing, na sinundan ng mga pag-uusap sa pagbisita ni Lisa Su, punong ehekutibo ng AMD, sa South Korea noong Oktubre 7.
Ganito ang pagkakasunod-sunod ng mga iniulat na kaganapan at nakatakdang sesyon sa summit:
- Marso 2026: Nilagdaan ng Samsung at AMD ang memorandum ng kanilang kooperasyon; nagpresenta rin ang Samsung ng teknolohiya sa Nvidia GTC.
- Hunyo at Agosto 2026: Nagpresenta ang Samsung sa COMPUTEX at sa Future of Memory and Storage conference, ayon sa pagkakasunod.
- Oktubre 7, 2026: Bumisita si Lisa Su sa South Korea at nakipagpulong kay Jeon Young-hyun, vice chairman ng Samsung DS Division, upang talakayin ang kooperasyon sa memory at computing; inilalarawan din ng mga ulat ang mga pag-uusap tungkol sa foundry.
- Oktubre 12, 2026: Nagsimula ang summit at nakatakda sa araw na iyon ang executive presentation ni Shim.
- Oktubre 13 hanggang 15, 2026: Kabilang sa programa ng Samsung ang mga sesyon tungkol sa pag-aayos ng mga tier ng KV cache, pag-optimize ng storage at arkitektura ng shared CXL memory.
Nakilahok ang Samsung bilang Diamond Sponsor. Magkakaiba ang mga ulat kung Oktubre 12, lokal na oras, o pahayag ng kumpanya noong Oktubre 13 ang dapat ituring na petsa ng anunsiyo ng estratehiya. Maaaring tumukoy ang mga petsang ito sa magkakaibang yugto ng iisang kaganapan. Inilalagay ng isang ulat ang summit sa San Francisco, samantalang San Jose convention center ang tinutukoy sa opisyal na iskedyul ng Samsung.
Hindi pinatutunayan ng laki ng merkado ang kahandaang magkomersiyal
Ayon sa iniulat na pananaliksik sa industriya, nanguna ang Samsung sa ikalawang quarter ng 2026 na may 39% ng pandaigdigang kita sa DRAM at 29.3% ng merkado ng NAND flash. Kinikilala ang Counterpoint Research bilang pinagmulan ng bilang para sa DRAM at ang TrendForce naman para sa NAND. Mga sukat ito ng bahagi sa merkado, hindi ng bahagi sa mga umuusbong na merkado ng CXL o processing in memory.
Binanggit ang Omdia bilang tagahula na magkakaroon ang Samsung ng pinakamalaking produksiyon ng mga DRAM at NAND wafer sa industriya sa buong taon. Tinataya naman ng hiwalay na pagtataya na aabot sa humigit-kumulang 8.175 milyong wafer, katumbas ng 300mm wafer, ang taunang kapasidad nito sa DRAM. Hindi katumbas ng aktuwal na produksiyon ang kapasidad, at hindi rin pinatutunayan ng alinmang bilang kung gaano kalaki ang ilalaan sa mga teknolohiyang ipinakita sa OCP.
Nagbigay rin ang isang ulat ng pambihirang laki ng paunang bilang para sa ikatlong quarter noong Oktubre 8: kita na 195 trilyong won at operating profit na 107.4 trilyong won, kung saan tumaas nang 782.5% ang kita kumpara sa nakaraang taon. Hindi pinagtitibay dito ng opisyal na ulat pampinansyal ang mga bilang na ito, kaya hindi dapat ituring ang mga ito bilang matibay na ebidensiya ng kinita mula sa mga teknolohiyang ipinakita sa summit.
Umuusad din ang kompetisyon lampas sa HBM. Inilalarawan ng mga ulat ang Memory-Centric AI Rack System ng SK hynix, o MARS, bilang CXL memory pool na pinagsasaluhan sa loob ng isang rack. Kaayon ito ng pagsisikap ng Samsung na gawing maaabot ng iba’t ibang sistema ang ekstrang memory, bagaman walang maihahambing na benchmark na nagpapakitang mas mahusay ang alinman sa dalawang paraan.
Layunin ng Samsung, ayon sa pahayag nito, na palakasin ang pagiging mapagkumpitensya ng HBM, server DDR5 at enterprise SSD. Kabilang sa mga hindi pa malinaw na detalye sa komersiyalisasyon ang pagkakaroon ng HBM5, presyo, mas malawak na pagtanggap ng customer at independiyenteng pagpapatunay sa mga pahayag tungkol sa performance. Mga petsa ng demonstrasyon at talakayan ang nasa programa ng summit, hindi tiyak na mga takdang petsa ng paglabas para sa bawat teknolohiya.
Mahahalagang Punto
- Pinagsasama ng estratehiya ng Samsung sa OCP 2026 ang mas mabilis na memory, pagpapalawak ng kapasidad sa pamamagitan ng CXL at SSD storage na nagpapanatili ng datos.
- Ginagamit ng pakikipagtulungan sa AMD ang teknolohiyang CMM-D memory upang tugunan ang lumalaking pangangailangan ng AI sa memory.
- Iniulat ng hiwalay na demonstrasyon ng elastic pooling na hanggang 38% na mas maikli ang oras bago lumabas ang unang token at 3.3 ulit na mas mataas ang goodput.
- Kabilang sa mga resulta ng pagsusuri sa LPDDR5X-PIM ang hanggang tatlong ulit na performance sa inference sa Edge AI Accelerator ng Samsung.
- Tinutugunan ng PM1763 storage, pag-optimize ng KV cache at pagproseso sa loob ng mga SSD ang magkakaibang hadlang sa paglilipat ng datos.
- Hindi pinatutunayan ng mga anunsiyo sa summit ang mga petsa ng pagpapadala ng HBM5 o ang malawakang komersiyal na pagkakaroon nito.