Ang Gumagawa ng Telepono na Kakaiba ang Nagawa sa AI Inference
Sa isang Lunes ng umaga na ikinagulat ng industriya ng teknolohiya, gumawa ang Xiaomi ng isang bagay na hindi inaasahan ng iilang tagamasid. Inihayag ng kumpanyang higit na kilala sa abot-kayang smartphone, de-kuryenteng scooter, at air purifier para sa bahay na nalampasan nito ang isang malaking hadlang sa bilis ng artificial intelligence. Ang bago nitong MiMo-V2.5-Pro-UltraSpeed serving mode ay lumilikha ng mahigit 1,000 token bawat segundo sa isang modelong may isang trilyong parameter, at umabot sa halos 1,200 token sa mga live na demonstrasyon. Hindi ito pinasimpleng bersyon ng modelo. Ito ang buong flagship na MiMo-V2.5-Pro, isang makabagong AI system na karibal ng Claude Opus sa mga coding benchmark.
Mga Nilalaman
- Ang Gumagawa ng Telepono na Kakaiba ang Nagawa sa AI Inference
- Ano Talaga ang Kahulugan ng 1,000 Token Bawat Segundo
- Paano Nalampasan ng Xiaomi ang mga Higante ng Custom Chip
- Ang Tatlong Teknik sa Likod ng UltraSpeed
- Bakit Nagbubukas ng Ganap na Bagong mga Gamit ang Bilis
- Akses, Presyo, at Open Source na Paglalabas
- Ang Tahimik na Pag-angat ng Xiaomi Bilang Higante sa AI
- Sa Maikling Pagsipat
Hindi lang bilis ang ikinagugulat sa anunsyo. Pati ang hardware na nagpapatakbo rito. Nakamit ng Xiaomi ang mga bilang na ito gamit ang iisang karaniwang node na may walong pangkaraniwang GPU, ang uri ng kagamitang mabibili sa alinmang malaking cloud provider. Walang custom silicon. Walang espesyalisadong chip na kasinlaki ng plato. Software innovation lang na tumatakbo sa hardware na maaaring rentahan ng mga developer ngayong gabi.
Ang mga parameter ay ang panloob na numerikal na timbang na nagtatakda kung paano nagpoproseso ng impormasyon ang isang AI model. Nangangahulugan ang isang trilyong parameter na kaya ng modelo na kumilala ng napakakumplikadong mga pattern sa teksto at code. Ang mga token naman ay mga bahagi ng tekstong binabasa at isinusulat ng modelo, at katumbas ang bawat isa ng humigit-kumulang tatlong-kapat ng isang salita. Kapag mahigit 1,000 token ang nalilikha nito bawat segundo, nangangahulugan itong gumagana ang napakalaking utak na ito sa bilis na dating itinuturing na imposibleng makamit nang walang dedikadong hardware.
Sa loob ng maraming taon, pinangibabawan ng mga startup ng chip na may malaking pondo at sariling disenyo ng silicon ang karera para sa mas mabilis na AI inference. Pinatunayan ngayon ng Xiaomi na kayang lampasan silang lahat ng mahusay na engineering sa karaniwang kagamitan. Nagbubunsod ang tagumpay na ito ng mahalagang tanong: kailangan ba talaga ang mamahaling espesyalisadong hardware kung kayang maghatid ng mas mahusay na resulta ang matalinong pag-optimize ng software sa madaling maabot na imprastraktura?
Ano Talaga ang Kahulugan ng 1,000 Token Bawat Segundo
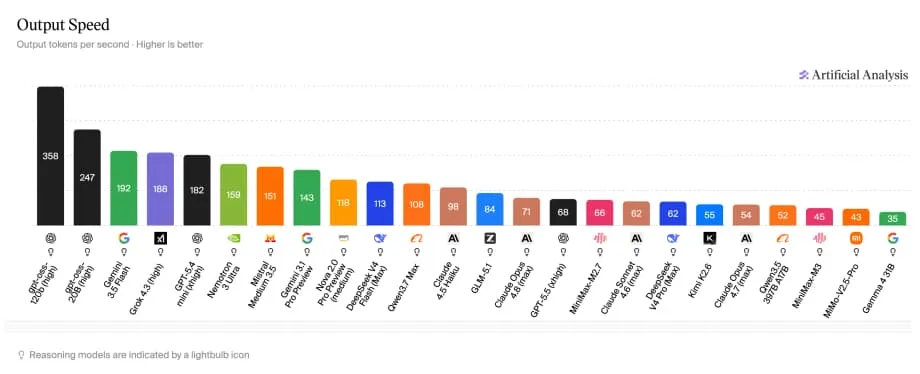
Para maunawaan kung bakit mahalaga ang bilang na ito, tingnan ang karanasan ng mga karaniwang gumagamit ngayon. Ayon sa benchmark data mula sa Artificial Analysis, lumilikha ang GPT-5.5, ang modelong nagpapatakbo sa karamihan ng mga pag-uusap sa ChatGPT, ng humigit-kumulang 68 token bawat segundo. Tumatakbo ang Claude Opus 4.6 sa bilis na humigit-kumulang 71 token bawat segundo, habang umaabot naman sa 98 ang mas magaan na Haiku model ng Anthropic. Mas mabilis ang Gemini Flash ng Google sa 192 token bawat segundo. Umaabot ang MiMo-V2.5-Pro-UltraSpeed sa 1,000 token bawat segundo sa modelong may isang trilyong parameter, halos 15 beses na mas mabilis kaysa sa mga chatbot na ginagamit araw-araw ng milyun-milyong tao.
Hindi basta maliit na dagdag ang agwat sa pagitan ng 68 at 1,000. Kumakatawan ito sa ganap na naiibang antas ng performance. Sa kasalukuyang bilis na nararanasan ng mga mamimili, naghihintay ang mga gumagamit nang ilang segundo bago lumitaw ang isang talata. Sa bagong bilis ng Xiaomi, halos kaagad na lilitaw ang isang buong pahina ng pagsusuri. Para sa mga developer na nagpapatakbo ng coding agent, binabago ng pagkakaibang ito ang karanasan mula sa mabagal na salitan ng mensahe tungo sa paraang kahawig ng kolaborasyong nagaganap sa real time.
Ang mga token ang pangunahing yunit ng malalaking language model. Kapag nag-type ka ng prompt, hinahati ng modelo ang teksto mo sa mga token para maproseso. Kapag sumasagot ito, paisa-isa itong lumilikha ng mga token at hinuhulaan ang bawat isa batay sa lahat ng nauna rito. Kapag mas mabilis lumikha ng token ang isang modelo, mas mabilis ang tugon nito at mas maraming gawaing natatapos sa mahigpit na takdang oras. Tinutukoy rin ng bilis kung ilang kahilingan ang kayang asikasuhin ng server nang sabay-sabay, na direktang nakaaapekto sa gastos at kakayahang palawakin ang serbisyo para sa mga negosyo.
Nakagagawa na ng sagot ang naunang Flash model ng MiMo-V2.5-Pro sa bilis na 150 token bawat segundo, o humigit-kumulang 110 salita bawat segundo, na mas mabilis kaysa sa pinakamabilis na kayang basahin o bigkasin ng tao. Itinataas nang husto ng UltraSpeed ang hangganang ito, at lumilikha ng bilis na lampas sa kakayahan ng pag-iisip ng tao. Dahil dito, nagiging posible ang mga workflow na pinapatakbo ng makina na hindi pa kayang gawin noon.
Paano Nalampasan ng Xiaomi ang mga Higante ng Custom Chip
Daan-daang milyong dolyar ang ipinuhunan ng mga kumpanyang gumagawa ng espesyalisadong hardware upang lutasin ang bottleneck sa bilis ng AI inference. Dinisenyo ng Cerebras ang isang wafer-scale chip na halos kasinlaki ng plato, na may 44GB na memorya sa loob ng chip para alisin ang mga limitasyon sa bandwidth. Umabot sa 969 token bawat segundo ang disenyo nito, isang kahanga-hangang tagumpay, ngunit sa Llama 3.1 405B ng Meta, isang modelong may 405 bilyong parameter. Wala pang kalahati iyon ng laki ng MiMo-V2.5-Pro. Gumawa naman ang Groq ng custom na arkitektura ng Language Processing Unit na may kakayahang umabot sa 300 hanggang 750 token bawat segundo depende sa modelo. Hindi tumatakbo ang alinman sa dalawang system sa karaniwang cloud hardware na maaaring rentahan ng mga developer mula sa mga provider gaya ng AWS.
Ganap na binaligtad ng paraan ng Xiaomi ang ganitong modelo. Sa pakikipagtulungan sa inference partner nitong TileRT, nakamit ng kumpanya ang rekord sa pamamagitan ng tinatawag nitong extreme model system codesign, o koordinadong pag-optimize sa AI model at sa software engine na nagpapatakbo rito. Ang resulta: isang modelong may isang trilyong parameter na mas mabilis tumakbo kaysa sa espesyalisadong silicon gamit ang mga pangkaraniwang GPU. Kung mapagtitibay ng independiyenteng pagsusuri ang mga benchmark na ito, ipinahihiwatig ng tagumpay na kayang lampasan ng inobasyon sa software ang mga limitasyon ng hardware na inakala ng marami na mangangailangan ng custom chip para malutas.
May malaking epekto sa ekonomiya ang pag-unlad na ito. Nangangailangan ng napakalaking puhunan, matagal na siklo ng pagdidisenyo, at espesyalisadong pagmamanupaktura ang custom silicon. Nakikinabang naman ang mga pangkaraniwang GPU sa malakihang produksyon, malawakang pagkakaroon, at tuluy-tuloy na pagpapahusay mula sa NVIDIA at iba pang manufacturer. Sa paglutas sa problema ng inference sa pamamagitan ng software, posibleng pinalawak ng Xiaomi ang akses sa bilis na dating para lamang sa mga laboratoryong may malaking pondo at sariling hardware.
Nagdaragdag pa ng isa pang dimensyon sa pagpapalawak ng akses na ito ang paglalabas ng FP4-DFlash checkpoint sa Hugging Face. Maaari nang suriin, subukan, at iakma ng mga mananaliksik at developer sa buong mundo ang modelong pinagbabatayan nito nang hindi bumibili ng pagmamay-aring hardware o kumukuha ng lisensyang pang-enterprise. Sa pagpapatunay ng komunidad malalaman kung mailalapat din ang mga paraang ito sa iba't ibang modelo at gamit.
Ang Tatlong Teknik sa Likod ng UltraSpeed
Nakasalalay ang tagumpay sa tatlong teknik na magkakaugnay at nagtutulungan. Walang isa sa mga ito ang makakamit nang mag-isa ang rekord sa bilis, ngunit kapag pinagsama, nalalampasan nila ang hangganang 1,000 token.
Ang unang teknik ay FP4 quantization. Karamihan sa malalaking modelo ay tumatakbo sa 16-bit o 8-bit na numerikal na precision, na nangangahulugang nangangailangan ang bawat parameter ng dalawang byte o isang byte ng memorya. Ikinokompress ng Xiaomi sa 4-bit precision ang mga expert layer, na bumubuo sa karamihan ng isang trilyong parameter. Pinabababa nito ang gamit sa memorya at ang pressure sa bandwidth, kaya mas mabilis na naipapasa ang data sa system. Ang panganib ng quantization ay pagkawala ng kalidad, dahil maaaring pahinain ng mas mababang precision ang kakayahan ng modelo sa pangangatwiran. Tiyak ang paraang ginamit ng Xiaomi: ang mga expert layer lang ang ikinokompress habang nananatili sa buong precision ang iba pang bahagi ng modelo. Ayon sa kumpanya, halos wala itong idinudulot na pagkawala ng kalidad.
Ang ikalawang teknik ay DFlash speculative decoding. Gumagamit ang tradisyonal na speculative decoding ng mas maliit na draft model para mabilis na hulaan ang susunod na ilang token, saka ibeberipika ng malaking modelo ang mga hulang iyon nang sabay-sabay. Ganap na inaalis ng DFlash ang sunod-sunod na hakbang ng pagbuo ng draft. Sa halip, pinupunan nito ang isang buong bloke ng mga nakatakip na posisyon sa iisang forward pass. Sa mga coding task, tinatanggap ng malaking modelo ang average na 6.3 sa 8 iminungkahing token sa bawat round ng beripikasyon. Nangangahulugan ito na anim na token ang sumusulong sa iisang hakbang sa halip na isa, kaya malaki ang bilis ng paglikha.
Ang ikatlong bahagi ay ang TileRT mismo, ang inference engine na nagpapanatili sa buong compute pipeline sa GPU sa lahat ng oras. Madalas na paisa-isa ang paglulunsad ng mga operator sa karaniwang serving system, kaya nagkakaroon ng maliliit na puwang sa pagpapatakbo. Inaalis ng TileRT ang overhead ng paglulunsad sa bawat operator at tuluy-tuloy nitong pinadadaloy ang data. Kapag pinagsama sa mga na-compress na timbang ng modelo at makabagong decoding strategy, napapanatili ng engine ang throughput na dati ay hindi makamit sa karaniwang hardware.
Tinatawag ng Xiaomi na extreme model system codesign ang kombinasyong ito, at angkop ang paglalarawang iyon. Pinatitibay ng bawat antas ng pag-optimize ang iba pa, kaya lumilikha ang kabuuan ng resultang hindi kayang ihatid ng alinmang teknik nang mag-isa.
Bakit Nagbubukas ng Ganap na Bagong mga Gamit ang Bilis
Walang saysay ang mga hilaw na benchmark kung wala silang ginagawang bago. Sa bilis na 1,000 token bawat segundo, nagbubukas ang MiMo-V2.5-Pro-UltraSpeed ng mga posibilidad na hindi pa kayang abutin ng mas mababagal na system.
Isaalang-alang kung paano ginagamit ngayon ng mga developer ang malalaking language model sa mahihirap na gawain. Kapag naharap sa komplikadong problema sa coding, karaniwang naghihintay ang gumagamit ng isang sagot at umaasang tama ito. Sa UltraSpeed, kayang magpatakbo ng parehong gumagamit ng dose-dosenang landas ng pangangatwiran nang sabay-sabay sa loob ng parehong real-time na takdang oras, habang awtomatikong bineberipika at itinatama ng system ang sarili nito sa background. Kayang siyasatin ng modelo ang maraming solusyon nang sabay-sabay sa halip na kumapit sa iisang daloy ng pangangatwiran. Lubos nitong binabago ang AI mula sa sunod-sunod na katulong tungo sa tagalutas ng problemang kayang magtrabaho nang sabay-sabay sa maraming paraan.
Agad na makikinabang ang mga industriyang may mahihigpit na limitasyon sa latency. Kailangang masuri ng mga sistema sa pagtukoy ng pandaraya ang mga transaksyon sa loob ng ilang millisecond. Hindi kayang maghintay nang ilang segundo ang pagbuo ng mga real-time na signal sa trading. Nangangailangan ang mga siklo ng autonomous agent, kung saan mabilis na nagmamasid, nagpapasya, at kumikilos ang mga AI system, ng bilis na hindi kayang ihatid ng mga chatbot para sa mamimili. Sa 68 token bawat segundo, nahaharap sa nakaiinis na bottleneck ang mga aplikasyong ito. Sa 1,000 token bawat segundo, nagiging posible na ang mga ito sa karaniwang cloud infrastructure.
Kahit sa pang-araw-araw na coding workflow, binabago ng bilis ang karanasan. Dati, nakatitig lang sa screen ang mga developer habang hinihintay matapos ang inference. Kapag papalapit at lumalampas sa 1,000 token bawat segundo ang bilis ng output, halos nawawala ang paghihintay. Nagbabago ang ugnayan mula sa paghiling at paghihintay tungo sa tunay na kolaborasyon sa real time kasama ang AI. Agad na nagkakaroon ng praktikal na halaga ang ganitong bilis ng pagtugon para sa mga aplikasyon sa pangangalagang pangkalusugan na nangangailangan ng mabilis na pagsusuri ng datos ng pasyente, at sa mga investment platform na nagpoproseso ng live na datos ng merkado.
Akses, Presyo, at Open Source na Paglalabas
Hindi ikinukubli ng Xiaomi ang teknolohiyang ito sa likod ng saradong pinto. Naglunsad ang kumpanya ng limitadong API trial na tatakbo mula Hunyo 9 hanggang Hunyo 23, 2026. Kailangang mag-apply para makakuha ng akses, at hindi garantisado ang pag-apruba. Bibigyang-priyoridad ang mga gumagamit na pang-enterprise at propesyonal na developer na may malinaw na pangangailangan sa negosyo. Dahil limitado ang mga mapagkukunan para sa mabilis na inference, maaaring sumali sa pila nang hanggang sampung beses bawat araw ang bawat account, at may hanggang 30 minuto ang bawat session. Awtomatikong ilalabas ang mga session na walang aktibidad nang mahigit limang minuto.
Sinasalamin ng presyo ang premium na bilis nito. Tatlong ulit ng karaniwang presyo ng MiMo-V2.5-Pro ang halaga ng UltraSpeed, ngunit nagbibigay ito ng humigit-kumulang sampung ulit na bilis sa paglikha. Bilang paghahambing, mas mura na nang malaki ang karaniwang MiMo-V2.5-Pro kaysa sa Claude Opus: humigit-kumulang $0.43 kada isang milyong input token at $0.87 kada isang milyong output token ang singil nito, kumpara sa $5 para sa input at $25 para sa output kada isang milyong token ng Opus. Kahit tatlong ulit ang presyo, mas mura pa rin nang malaki ang pinabilis na serbisyo ng Xiaomi kaysa sa maraming kakompetensiyang makabagong modelo.
Para sa mga developer na gustong direktang subukan ang teknolohiya, inilabas ng Xiaomi bilang open source sa Hugging Face ang pinagbabatayang MiMo-V2.5-Pro-FP4-DFlash checkpoint. Naglabas din ang TileRT ng piling mga module sa GitHub. Inaanyayahan ng hakbang na ito ang pandaigdigang komunidad ng pananaliksik na beripikahin ang mga benchmark, mag-eksperimento sa arkitektura, at posibleng iakma ang mga teknik sa iba pang modelo. Hindi pa malawakang nailalathala ang beripikasyon ng mga independiyenteng ikatlong partido, kaya magsisilbing tunay na pagsubok sa mga darating na linggo ang pagsusuri ng komunidad sa pamamagitan ng mga open release na ito.
Ang Tahimik na Pag-angat ng Xiaomi Bilang Higante sa AI
Para sa karamihan ng mga mamimili, nananatiling tatak ang Xiaomi na nagbebenta ng abot-kayang elektronikong kagamitan. Nakapagbenta ang kumpanya ng milyun-milyong smartphone, de-kuryenteng scooter, at air purifier sa mga pandaigdigang merkado. Natabunan ng ganitong imahen nito sa mga mamimili ang unti-unting paglago ng dibisyon nito sa artificial intelligence, na hindi pinansin ng karamihan sa industriya hanggang ngayon.
Nakipagsabayan na ang MiMo-V2.5-Pro sa Claude Opus sa karamihan ng mga coding benchmark nang ilunsad ito noong Abril. Hindi nagpapakilala ang UltraSpeed ng bago o pinasimpleng modelo. Pinabibilis nito ang mismong makabagong katalinuhang nakikipagkompetensiya na sa pinakamataas na antas. Mabisa nang nakabuo ang tatak ng mga telepono ng kakayahan sa AI na karibal ng mga espesyalisadong laboratoryo, habang nananatiling mas mura nang sampung ulit.
Kung mapagtitibay ng independiyenteng pagsusuri ang mga pahayag tungkol sa bilis, makakamit ng Xiaomi ang pambihirang tagumpay nang hindi gumagastos ng daan-daang milyong dolyar para sa custom silicon, gaya ng kinailangan ng mga kumpanyang tulad ng Cerebras at Groq. Maipakikita nitong kayang maghatid ng nangungunang performance sa larangan ang pag-optimize ng software sa pangkaraniwang hardware. Babaguhin ng resultang iyon ang mga palagay tungkol sa pinagmumulan ng kakayahan ng AI at kung sinu-sino ang kayang makipagkompetensiya sa pinakamataas na antas. Kabilang na ngayon sa mga nangungunang innovator sa AI infrastructure ang isang higanteng kompanya ng consumer electronics mula Beijing, at karaniwang GPU ang dala nito sa halip na custom silicon.
Sa Maikling Pagsipat
- Lumilikha ang MiMo-V2.5-Pro-UltraSpeed ng Xiaomi ng mahigit 1,000 token bawat segundo sa modelong may isang trilyong parameter gamit lamang ang walong karaniwang GPU, nang hindi nangangailangan ng custom silicon.
- Humigit-kumulang 15 ulit itong mas mabilis kaysa sa GPT-5.5 at Claude Opus. Nakamit ang bilis sa pamamagitan ng FP4 quantization, DFlash speculative decoding, at TileRT inference engine.
- Tatakbo ang limitadong API trial mula Hunyo 9 hanggang Hunyo 23, 2026. Tatlong ulit ng karaniwang presyo ng MiMo ang singil para sa tinatayang sampung ulit na bilis sa paglikha, at bibigyang-priyoridad ang mga gumagamit na pang-enterprise at propesyonal na developer.
- Inilabas ng Xiaomi bilang open source sa Hugging Face ang FP4-DFlash checkpoint, upang masuri at maiakma ng komunidad ang mga teknik.
- Kung mapagtitibay ng mga independiyenteng pagsusuri, ipinahihiwatig ng tagumpay na kayang higitan ng pag-optimize ng software sa karaniwang cloud hardware ang mamahaling solusyon gamit ang custom chip mula sa mga kumpanyang espesyalisado sa AI hardware.